Referencia del lenguaje
En esta referencia se trata la estructura del conjunto de fórmulas.
Estructura del conjunto de fórmulas
Un conjunto de fórmulas consta de una lista de términos enlazados y finalizados mediante el carácter ;, así como, opcionalmente, de comentarios y construcciones de control.
Steuerkonstrukt
Term 1;         // optionaler Kommentar
Term 2;
Term 3;         /* Beschreibung */
Términos
Un término es
-
un valor booleano o numérico constante, o una cadena de caracteres
Ejemplos:false,14,-23.5,"Hello" -
un nombre de variable
Ejemplos:Speed,$"GPS.Location" -
un término agrupado mediante un operador de paréntesis
Ejemplos:(Term + Term) * Term,[Term, Term, Term], -
un término modificado mediante un operador unario
Ejemplos:! Term,- Term,~ Term -
un par de términos enlazados mediante un operador
Ejemplos:Term = Term,Term + Term,Term ? Term : Term -
una lista de términos enlazados mediante operadores
,Term, Term, Term, ... -
una llamada a función
funktion(...) -
un objeto de configuración delimitado por
{...}.
El objeto de configuración sigue una sintaxis propia, p. ej. una codificación JSON simplificada.
Los términos, operadores y funciones se procesan exclusivamente según la disponibilidad temporal de los datos; el orden en que están escritos no influye en el cálculo.
Comentarios
Los comentarios, como en los lenguajes de programación C y C++, empiezan con // y terminan entonces automáticamente al final de la línea, o bien empiezan con /* y terminan con */. La notación /* ... */ puede aplicarse de forma anidada, como en una expresión entre paréntesis.
// Im Kommentar beginnt "-hier keine Zeichenkette und [-hier keine Matrix

s1 = "dies ist ein Text"; // ab hier Kommentar
s2 = "hier geht's gleich wieder weiter";

// Hilfreiche Markierung für komplexe Datenstrukturen
Tensor = [ /* Slice 1: */ [ [111, 112]
                          , [121, 122] ]
         , /* Slice 2: */ [ [211, 212]
                          , [221, 222] ]
         , /* Slice 3: */ [ [311, 312]
                          , [321, 322] ] ];

/* Dieser Abschnitt ist nur für die Inbetriebnahme
T1 = 12.34 * Tensor;
 */
La secuencia de caracteres // no se tiene en cuenta cuando se encuentra dentro de una cadena marcada con "..." o '...' o dentro de un comentario /* ... */. En el ejemplo, por tanto, las asignaciones a a y e no se interpretan, pero sí la asignación a z.
/* Im Block-Kommentar wird // ignoriert */
s1 = "Dies ist ein //-Text und weder ein Kommentar noch eine Formel: 1+1";
/*
a = b + c;
e = f * g;
// */  z = b / g;
Las marcas de inicio y fin de comentario /*...*/ no se tienen en cuenta cuando están escritas después de un // «visible». En el ejemplo, el bloque de comentario está ahora él mismo comentado, las asignaciones a a y e se ejecutan, pero ya no la asignación a z.
// Im Zeilen-Kommentar werden /* und */ ignoriert
// /*
a = b + c;
e = f * g;
// */ z = b / g;
Si un comentario de bloque /*...*/ iniciado no se cierra, se muestra un error.
Construcciones de control
Las construcciones de control comienzan al principio de la línea con un carácter # y se extienden hasta el siguiente final de línea que no esté oculto dentro de un nivel de paréntesis. La estructura de una construcción de control sigue, según la función, una sintaxis definida en consecuencia. Pueden insertarse comentarios.
#controlA <parameter>
#controlB <name>[<parameter>](<parameter>){<code>}
#controlC <key>, <key>=<value>, …
Mediante las construcciones de control se pueden influir en las funciones del compilador del módulo Math, en el procesamiento de las variables y en la ejecución del código.
Una construcción de control puede tener, por tanto, efectos sobre los términos escritos a continuación.
Las construcciones de control se recopilan en este documento.
Implementación de la funcionalidad deseada
Caja de herramientas
Para implementar la funcionalidad deseada se dispone de funciones y operadores en las siguientes categorías:
- operadores aritmético-lógicos
- funciones matemático-trigonométricas
- funciones de filtrado temporal (como, p. ej., diferenciación e integración de funciones)
- algoritmos numéricos (p. ej. FFT, descomposición de matrices, interpolación, predicción)
- muestreo (sampling) de datos de medición
- funciones de conteo y temporizadores
- funciones de selección, funciones orientadas a bits y funciones para la conversión de tipos de datos (casts)
- la compatibilidad con secuencias de expresiones y asignaciones
- funciones de texto (cadenas)
A medida que avanza el desarrollo del módulo Math, se incorporan continuamente nuevas funciones y, naturalmente, también se corrigen errores en las funciones existentes. Según la versión de smartCORE desplegada, se dispone de una versión determinada. Esta se muestra, en forma de número de catálogo correlativo, también en el archivo de registro; en el ejemplo, V11:
...|...|...|INFO   |module.math:  (II)  "Welcome to mathExpression library, git '0ed7f17-dirty', build 'Feb  2 2026 15:30:55'"
...|...|...|INFO   |module.math:  (II)  "Package 'mathExpCore', V11 (using V11)"
Ejecución condicional, bucles
Debido al procesamiento continuo de datos en flujo con marca de tiempo, cada término debe entenderse como un componente eléctrico o un filtro en un circuito eléctrico. Con ello, la implementación de construcciones de control clásicas que influyen en el flujo del texto de las fórmulas carece de sentido. Por este motivo, los siguientes elementos del lenguaje, o sus variantes, no se encuentran en el módulo de cálculo:
- IF-THEN-ELSE
- WHILE-DO
- REPEAT-UNTIL
- FOR-TO-DO, FOR-EACH
- SWITCH-CASE
Sin embargo, existen diversas funciones con las que, por ejemplo, se puede elegir entre distintas fuentes de señal. Esto equivaldría a un relé o a un multiplexor en la técnica de circuitos.
Otras funciones permiten almacenar valores en un instante determinado o detectar cambios de valor o flancos.
Por motivos similares, por el momento no existe ninguna implementación para procedimientos o funciones definidos por el usuario.
Cálculo con corrección temporal
Todos los términos, operadores y funciones procesan y producen siempre datos con marca de tiempo, que son precisamente característicos de smartCORE. Estos datos se calculan entre sí con corrección temporal, calculándose por lo general un valor de salida para cada marca de tiempo de entrada de los flujos de datos que intervienen en un término. En ello se supone que la evolución de la señal entre dos marcas de tiempo es constante (retenedor de orden cero) con referencia al valor más antiguo en el intervalo de tiempo, es decir, que el valor más antiguo es válido hasta inmediatamente antes de la marca de tiempo del valor más reciente. Por tanto, el procesamiento posterior de los datos solo puede realizarse si, en un instante dado, todos los valores de entrada que intervienen en el término tienen también valores válidos. El intervalo de tiempo válido para el cálculo termina, para un flujo de datos, con su marca de tiempo más reciente. La tabla siguiente muestra un ejemplo con dos fuentes de datos con marca de tiempo A y B y un cálculo:
| Instante | A | B | A + B |
|---|---|---|---|
| 1 | (no definido) | 10 | (no definido) |
| 2 | 5 | 15 | |
| 3 | 20 | 25 | |
| 5 | 30 | 35 | |
| 8 | 8 | 38 | |
| 13 | 9 | 40 | 49 |
| 26 | 5 | 45 | |
| 27 | 2 | 42 | |
| 30 | (pendiente) | 50 | (pendiente) |
Esto significa de forma inmediata que, para los datos que se proporcionan solo raramente o que, por ejemplo, dejan de suministrarse por completo al desconectar un componente del sistema, todos los cálculos que dependen de ellos se procesan en primer lugar solo hasta esa marca de tiempo más reciente y quedan bloqueados allí. El módulo Math ofrece varias posibilidades para mitigar estas situaciones de bloqueo.
Con el parámetro evaluationTimeMs solo se establece el intervalo de tiempo en ms en el que el intérprete procesa, sobre todos los términos, todos los puntos de datos disponibles en ese instante (procesamiento por lotes). Esto lleva asociada una cierta «potencia reactiva». Por ello, el intervalo debería elegirse al menos tan largo como para que en cada ciclo también puedan procesarse datos, pero preferiblemente también tan corto como para que el número de puntos de datos individuales se mantenga en un orden manejable (aprox. < 100). Si, por ejemplo, solo se tienen fuentes de datos que proporcionan nuevos valores cada 2 segundos, se podría ajustar evaluationTimeMs a 5000 ms. En el caso de fuentes de datos que suministran sus puntos de datos a 1 kHz, es más razonable un evaluationTimeMs de 100 ms. Un tiempo de ciclo más corto también es razonable cuando los resultados del conjunto de fórmulas deban utilizarse para realizar tareas de control en el proceso.
Debido al procesamiento de los datos con corrección temporal, el orden de las expresiones en el conjunto de fórmulas no tiene, en definitiva, ninguna importancia. No obstante, por motivos de legibilidad se recomienda utilizar únicamente variables a las que se haya asignado un valor previamente.
Cálculo en tiempo discreto
El cálculo con corrección temporal no puede realizarse cuando las variables se realimentan con una referencia circular a sí mismas. Un ejemplo de tal construcción es la implementación de un sencillo algoritmo de filtro ponderado:
y_out = weight * y_out + (1 - weight) * x_in;
Según la regla introducida anteriormente, y_out se recalcula para todos los instantes definidos por los datos de entrada weight, y_out y x_in. Mientras que weight y x_in se establecen de forma independiente como constantes (por tanto, siempre válidas) o se continúan a partir de una señal de medición, y_out no se rellena inicialmente en absoluto. ¿Qué define el primer valor de y_out? Y si este se establece con marca de tiempo, y_out solo puede calcularse como máximo hasta exactamente esa marca de tiempo, es decir, no puede calcularse en absoluto, porque ese instante ya está asignado.
En la técnica de regulación y control, así como en los lenguajes de programación, la expresión anterior se interpreta, sin embargo, de modo que el «nuevo» valor de y_out resulta, según la regla, del «antiguo» y_out. El «nuevo» y_out se sitúa entonces un paso de muestreo en el futuro, de modo que el siguiente cálculo puede ejecutarse en consecuencia.
El módulo Math detecta las referencias circulares (también indirectas) y convierte las variables afectadas a una regla de cálculo discreta. Las variables avanzan ahora en un intervalo de tiempo y una trama fijos, que se determinan mediante el parámetro discreteSampleTimeMs. Todos los cálculos discretos se sincronizan con esa trama.
Para resolver la cuestión del valor inicial se define una sintaxis especial que solo se ejecuta una vez: a la variable se le añade el sufijo @0 en la asignación del valor inicial:
y_out@0 = x_in;
y_out   = weight * y_out + (1 - weight) * x_in;
El primer valor disponible en la variable de entrada x_in se utiliza en este ejemplo como valor inicial en el punto de trama inmediatamente siguiente para y_out. A partir de ese momento, el cálculo y la asignación de y_out se ejecutan en el intervalo de tiempo fijo y alineado.
Debido al muestreo, los cambios rápidos de señal que se sitúan entre dos instantes de muestreo pueden perderse. catch(x, {...}) puede utilizarse para tener en cuenta del intervalo componentes de señal críticos más rápidos.
Identificadores y variables
Para los nombres de variables (señales, canales) se aplican las siguientes convenciones
- el primer carácter debe ser del grupo a-z, A-Z o _
- todos los caracteres siguientes deben ser del grupo a-z, A-Z, 0-9 o _
- se distingue entre mayúsculas y minúsculas
- ¡todos los caracteres no mencionados, como, p. ej., diéresis, caracteres especiales, paréntesis, símbolos matemáticos y espacios, no están permitidos!
Todos los identificadores distinguen entre mayúsculas y minúsculas (case-sensitive), es decir, "varIABLE", "Variable" y "VARiable" son tres identificadores distintos.
Es posible incluir en el cálculo los datos de canales de smartCORE existentes indicando el nombre del canal. Si para ello es necesario acceder a canales de smartCORE cuyo nombre incumple la regla anterior, existe una posibilidad mediante las siguientes notaciones
$'Some + strange.å =channel ů /name!'
$"Some + strange.å =channel ů /name!"
Lo mismo se aplica a los canales que deban devolverse a smartCORE y requieran una denominación especial.
Solo se puede realizar una asignación a una variable en un único punto. Las variables sin una asignación local se buscan como fuente de datos en el contexto de smartCORE. Esto también se aplica a las variables que representan salidas secundarias de un bloque funcional y que se definen con las propiedades.
Constantes
Los siguientes identificadores están disponibles como constantes en el contexto del texto de fórmulas:
| Identificador | Valor | Tipo |
|---|---|---|
| true | true | <bool> |
| on | true | <bool> |
| yes | true | <bool> |
| high | true | <bool> |
| false | false | <bool> |
| off | false | <bool> |
| no | false | <bool> |
| low | false | <bool> |
| pi | <dbl> | |
| magic | <uint> | |
| j | <cxFlt> |
Si en smartCORE existen variables con uno de estos nombres, la notación especial para las variables $'…' (véase Identificadores) puede garantizar la distinción. Por lo demás, tiene prioridad el uso del identificador como constante.
Tipos de datos y conversión de tipos
Tipos de datos
El módulo Math elige para el cálculo un tipo de datos adecuado en cada caso para poder ejecutar las operaciones deseadas con la mejor representación posible. Los tipos son los siguientes
| Tipo de datos | Designación | Descripción | Longitud en bits | Mínimo | Máximo |
|---|---|---|---|---|---|
| boolean | <bool> | Valor de verdad | 1 | false, no, off, low | true, on, yes, high |
| unsigned integer | <uint> | Número entero sin signo | 64 | 0 | 18446744073709551615 |
| integer | <int> | Número entero con signo | 64 | -9223372036854775808 | +9223372036854775807 |
| Resolución mínima | Rango de valores | ||||
| double | <dbl> | Número de coma flotante de precisión doble | 64 | ±5.0E-324 | ±1.7976931348623157E+308 |
| complex float | <cxFlt> | número complejo de coma flotante de precisión simple (*) | 2x 32 | ±1.175494E-38 por componente Re/Im | ±3.402823E+38 por componente Re/Im |
| string | <str> | Texto, UTF-8 | N/A | N/A | N/A |
Por lo general no es necesario ocuparse del tipo; al transferir a smartCORE se convierte de forma adecuada al tipo de datos indicado para ello.
En esta descripción de funciones, el tipo de datos se escribe habitualmente entre ángulos, es decir, p. ej. <bool> o <str>.
Conversión automática de tipos
Al procesar datos numéricos mediante operadores binarios se realiza la siguiente conversión automática de tipos con referencia a los tipos de los operandos
| bool | uint | int | dbl | cxFlt | str | |
|---|---|---|---|---|---|---|
| bool | bool | uint | int | dbl | cxFlt | str |
| uint | uint | uint | int | dbl | cxFlt | str |
| int | int | int | int | dbl | cxFlt | str |
| dbl | dbl | dbl | dbl | dbl | cxFlt | str |
| cxFlt | cxFlt | cxFlt | cxFlt | cxFlt | cxFlt | str |
| str | str | str | str | str | str | str |
Con ello se conservan el mayor tiempo posible
- los valores booleanos como solo true/false
- las propiedades de los valores uint para operaciones de bits
- el signo al utilizar valores int
- la precisión de los números de coma flotante
- el espacio de números complejos disponible
Particularidades de bool
-
En la conversión a
<bool>se aplica implícitamente la comparación de distinto de 0 para obtener el valor de verdad. -
En la conversión de
<bool>a un tipo numérico, false pasa a ser 0 y true pasa a ser 1. -
En la suma de dos valores booleanos, la conversión se realiza a
<uint>. -
En la resta de dos valores booleanos, la conversión se realiza a
<int>. -
En el cálculo con campos de datos de tipo
<bool>, el resultado es siempre<int>.
Particularidades de uint
-
En la resta de dos valores sin signo
<uint>-<uint>, el resultado es<int>si el segundo operando es mayor que el primero. Así se evita el desbordamiento, casi siempre absurdo y no deseado, en magnitudes de 2^64. -
En el cálculo con campos de datos de tipo
<uint>, el resultado es siempre<int>.
Conversión manual de tipos
También es posible realizar una conversión manual de tipos utilizando las siguientes funciones
| Función | Descripción |
|---|---|
bool(x) | Conversión del argumento x a bool |
uint(x) | Conversión del argumento x a uint |
int(x) | Conversión del argumento x a int |
dbl(x) | Conversión del argumento x a double |
str(x) | Conversión del argumento x a string |
Tipos numéricos
Directamente en el texto de fórmulas y en los objetos de configuración para las propiedades de las funciones, los valores numéricos también pueden indicarse en distintos sistemas numéricos. Ejemplos de notaciones son:
  aBool         = true;         // alt.: false, on, off, yes, no, high, low
  anUnsignedInt = 42;           // alt.: 42u
  aHexUInt      = 0x2A;         // alt.: 2Ah
  anOctUInt     = 052;          // alt.: 52o
  aBinUInt      = 0b10'1010;    // alt.: 101010b
  aSignedInt    = -42;
  aDouble       = 3.14159;      // alt.: 1.6022e–19, pi, !! decimal-point
  aComplex      = 2.7+1.0*j;    // alt.: cx(2.7, 1.0)
Separador de grupos
En los números enteros sin signo (<uint>) o con signo (<int>), los dígitos individuales pueden dividirse en grupos insertando una comilla simple '. Este carácter no influye en la interpretación del valor numérico, pero facilita la lectura. No debe aparecer al principio ni al final de un número.
aHexUInt      = FFe7'0815'337Eh;    // 0815 ist hier kein String!
aBinUInt      = 0b1011'0110'1010;
aLargeInt     = 1'000'000'000;
Signo y negación
Anteponiendo un operador - se forma el valor negativo en cualquier formato numérico (complemento a dos).
Anteponer el operador + está permitido, pero no tiene función.
El operador ~ invierte a nivel de bits el número entero de un <uint> (ejemplo: ~0b1010'0011'1100 -> 0b1111...1111'0101'1100'0011).
Formato numérico hexadecimal
La representación de un número en el sistema hexadecimal (base 16) se realiza anteponiendo 0x o 0X o añadiendo la letra h. Los dígitos posibles son 0 .. 9, a .. f o A .. F y el separador de grupos.
La indicación de un número en el sistema hexadecimal se interpreta siempre como sin signo, pero puede negarse con el operador - o invertirse con ~.
Formato numérico octal
La representación de un número en el sistema octal (base 8) se realiza anteponiendo un 0 (cero) o añadiendo la letra o. Los dígitos posibles son 0 .. 7 y el separador de grupos.
La indicación de un número en el sistema octal se interpreta siempre como sin signo, pero puede negarse con el operador - o invertirse con ~.
Formato numérico binario
La representación de un número en el sistema binario (base 2) se realiza anteponiendo 0b o 0B o añadiendo la letra b. Los dígitos posibles son 0 .. 1 y el separador de grupos.
La indicación de un número en el sistema binario se interpreta siempre como sin signo, pero puede negarse con el operador - o invertirse con ~..
Cadenas de caracteres (literales de cadena)
Las cadenas de caracteres constantes se encierran entre comillas simples ' o dobles ". Si una cadena contiene a su vez un ' o un ", este debe marcarse anteponiendo el carácter de escape \. Ejemplos:
s1a = '17" (inch)';
s1b = "17\" (inch)";
s2a = "Hat's funktioniert?";
s2b = 'Hat\'s funktioniert?';
En general, los caracteres especiales en cadenas, que se utilizan, por ejemplo, para expresiones regulares en la búsqueda de texto o en la interpretación o generación de protocolos de dispositivos serie, pueden representarse mediante las siguientes secuencias de escape:
| Carácter | Nombre ASCII | Valor ASCII | Secuencia de escape |
|---|---|---|---|
| Newline (Linefeed) | NL (LF) | 10 | \n |
| Horizontal tab | HT | 9 | \t |
| Vertical tab | VT | 11 | \v |
| Backspace | BS | 8 | \b |
| Carriage return | CR | 13 | \r |
| Formfeed | FF | 12 | \f |
| Alert | BEL | 7 | \a |
| Escape | ESC | 27 | \e |
| Backslash | \ | 92 | \\ |
| Question mark | ? | 63 | \? |
| Single quotation mark | ' | 39 | \' |
| Double quotation mark | " | 34 | \" |
| Carácter a partir de código octal | NNN = 000 .. 377 (dígitos octales) | \oNNN\o{N...} | |
| Carácter a partir de código decimal | NNN = 000 .. 255 (dígitos decimales) | \dNNN\d{N...} | |
| Carácter a partir de código hexadecimal | NN = 00 .. FF (dígitos hexadecimales) | \xNN\x{N...} | |
| Carácter(es) UTF a partir de código decimal | UTF8-Multibyte | NNNN = x0000 .. xFFFF x00000000 .. x0010FFFF | \uNNNN\UNNNNNNNN\u{N...} |
La codificación de los caracteres se realiza internamente siempre en UTF-8 (UTF-8 – Wikipedia).
Operadores aritmético-lógicos
En esta sección se tratan los operadores aritmético-lógicos, incluidos su jerarquía y su asociatividad.
Asociatividad
Denominamos a un operador ° asociativo por la izquierda si se cumple lo siguiente
a ° b ° c = (a ° b) ° c
y, correspondientemente, asociativo por la derecha si se cumple
a ° b ° c = a ° (b ° c)
Un operador * tiene una jerarquía (precedencia, fuerza de enlace) mayor que el operador + si, independientemente de las asociatividades de ambos operadores, se cumple
a + b * c = a + (b * c)
Se recomienda, cuando el enlace de términos no sea inmediatamente evidente, forzar el orden de evaluación previsto mediante un uso abundante de (...). Precisamente en el caso de los operadores lógicos o de comparación, la precedencia no siempre es conocida. En expresiones complejas se recomienda además utilizar varias líneas consecutivas y una alineación adecuada de los términos para estructurarlas.
res = A && (B || (C && D) || (E && (F || G)));    // Variante 1
opt = A && (    B                  // optionaler Kommentar
            || (C && D)            // optionaler Kommentar
            || (E && (   F         // optionaler Kommentar
                      || G)        // optionaler Kommentar
               )
           );                                    // Variante 2
Operadores
La tabla siguiente contiene los operadores disponibles, ordenados por precedencia ascendente. Todos los operadores aquí enumerados trabajan con los tipos de datos introducidos anteriormente. Para las operaciones y combinaciones lógicas orientadas a bits se dispone de funciones propias.
| Operador | Asignación | Asociatividad | Descripción | Ejemplo | Tipo de resultado |
|---|---|---|---|---|---|
| ; | izquierda | secuencia de instrucciones ejecutada con independencia del tiempo | y = 7; x = 4 | void | |
| , | izquierda | enumeración de expresiones individuales | a = 4, b = 6, a + b | como la última expresión | |
| += | SÍ | derecha | asignación compuesta de suma | a += 17 | automático |
| -= | SÍ | derecha | asignación compuesta de resta | a -= b | automático |
| *= | SÍ | derecha | asignación compuesta de multiplicación | a *= b | automático |
| /= | SÍ | derecha | asignación compuesta de división | a *= b | automático |
| %= | SÍ | derecha | asignación compuesta de módulo | b %= 4 | automático |
| = | SÍ | derecha | asignación | a = 23 * b | como la expresión asignada |
| ? : | derecha | operador ternario if-else | (a > 23) ? 12 : -50 | como el cuerpo resultante | |
| || | izquierda | disyunción lógica (OR) | a || b | <bool> | |
| && | izquierda | conjunción lógica (AND) | a && b | <bool> | |
| ^^ | izquierda | antivalencia lógica (XOR) | a ^^ b | <bool> | |
| == | izquierda | igualdad | a == b | <bool> | |
| != | izquierda | desigualdad | a != b | <bool> | |
< | izquierda | menor que | a < b | <bool> | |
<= | izquierda | menor o igual que | a <= b | <bool> | |
> | izquierda | mayor que | a > b | <bool> | |
>= | izquierda | mayor o igual que | a >= b | <bool> | |
| + | izquierda | suma | a + b | automático | |
| - | izquierda | resta | a - b | automático | |
| * | izquierda | multiplicación | a * b | automático | |
| / | izquierda | división | a / b | automático | |
| % | izquierda | módulo | a % b | automático | |
| ^ | derecha | potenciación | a ^ 0.333 | <dbl> | |
| ! | derecha | inversión lógica (NOT) | !(a && b) | <bool> | |
| ~ | derecha | inversión orientada a bits | ~a | <uint> | |
| + | derecha | signo positivo | 6 / +a | automático | |
| - | derecha | signo negativo | 9 * -a | automático |
Operadores de asignación
Solo se puede realizar una asignación a una variable en un único punto del texto de las fórmulas. Las variables sin una asignación local se buscan como fuente de datos en el contexto de smartCORE.
En los operadores de asignación debe haber obligatoriamente en el lado izquierdo una variable (x, y, …), un elemento de una matriz ya asignada previamente (V[2], M[0,2], …) o el inicializador de una variable muestreada de forma discreta (k@0, …) en la que se almacena el resultado. El resultado de la expresión sigue siendo el valor asignado. Con ello también es posible encadenar asignaciones o utilizar una asignación dentro de una expresión.
Operadores para campos de datos
Si los operadores +, -, * y / se aplican a campos de datos (vectores, matrices, tensores), se aplican las reglas habituales en matemáticas respecto a la dimensión de los operandos y a la dimensión resultante del resultado. Se aplican las siguientes reglas:
-
Para la suma y la resta, los campos de datos que intervienen deben tener la misma dimensión. La operación se realiza sobre los elementos con los mismos índices.
-
Un campo de datos puede multiplicarse libremente por un escalar:
DF * sos * DF. La operación se ejecuta para cada elemento. -
Un campo de datos solo puede dividirse por un escalar:
DF / sLa operación se ejecuta para cada elemento. -
Para la multiplicación, el primer campo de datos debe tener tantas columnas como filas tenga el segundo campo de datos. El resultado contiene tantas filas como el primer campo de datos y tantas columnas como el segundo campo de datos.
Como en el caso de los vectores no se distingue explícitamente entre vector fila y vector columna, se aplican las siguientes reglas:-
El producto de dos vectores de la misma longitud es siempre el producto escalar.
-
Para el producto vectorial de vectores de 2 y 3 componentes debe utilizarse la función
Cross(v1, v2). -
El producto de vector y matriz interpreta el vector como vector fila.
-
El producto de matriz y vector interpreta el vector como vector columna.
-
Igualdad de campos de datos
Dos campos de datos son iguales si y solo si coinciden exactamente en el tipo de datos, en la dimensión y en todos los elementos. Antes de la comparación no se realiza ninguna conversión automática de tipos. Dos campos de datos son distintos si no son iguales según la definición anterior.
No hay otras comparaciones disponibles.
Paréntesis
Los siguientes pares de paréntesis también se reconocen en expresiones anidadas. Cada paréntesis de apertura debe cerrarse correctamente y en el orden correcto.
| Agrupación | Significado | Ejemplo |
|---|---|---|
( ... ) | Agrupación en el orden de evaluación, agrupación de parámetros de función | (a+b)/2, max(a, b, 50) |
[ ... ] | Reservado para la representación de vectores, matrices y tensores y para la indexación de variables; la indexación cuenta siempre de 0…(N-1), para vectores: V[<idx>], no se distingue entre vector fila y vector columnapara matrices: M[<row>, <col>] para tensores: T[<slice>,<row>, <col>] | a = [1, 2, 3], b = [[1.1, 1.2], [2.1, 2.2]], a[1] + b[0,1] |
{ ... } | - Agrupación para objetos JSON que pueden utilizarse para parametrizar bloques funcionales. Como estos pueden llegar a ser muy extensos, se recomienda remitir mediante un enlace $ref: '<path>' a un recurso JSON externo, que se recopila en un contenedor aparte del módulo de cálculo. | timer({ interval: 60 }) |
? ... : | La expresión entre ? y : está implícitamente rodeada por (…). |
Funciones
Las funciones para el módulo Math las proporciona el propio plugin y, en el futuro, también otros plugins temáticos para el módulo Math, y están implementadas en principio en C++.
Llamada a función
Cada función consta de un nombre de función que sigue la sintaxis habitual de los identificadores
- el primer carácter es del grupo a-z, A-Z o _
- todos los caracteres siguientes son del grupo a-z, A-Z, 0-9 o _
- se distingue entre mayúsculas y minúsculas
seguido de una lista de parámetros que contiene, entre ( ... ), una lista de términos individuales separados por comas.
En la descripción de bloques funcionales complejos, los parámetros de la función también se denominan entradas y el valor de retorno de la función se denomina salida.
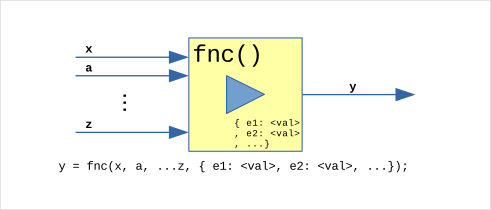
Los identificadores de espacios de nombres pueden anteponerse al nombre de la función mediante un '.'. Por lo demás, los identificadores de espacios de nombres siguen las mismas reglas.
Ejemplos de llamadas a función
   f1  = functionNoParam();
   f2  = functionOneParam(x);
   f3a = functionOptionalParam(x,a);
   f3b = functionOptionalParam(x,a,b);
   f3c = functionOptionalParam(x,a,b,c);
   f4  = functionWithConfig(x,y,z, {...});
Para los parámetros se distingue entre parámetros obligatorios y opcionales (entradas), así como un objeto de configuración para las propiedades de la función como último elemento. El significado de los parámetros puede variar con el número de parámetros utilizados; esto debe consultarse en la descripción de la función.
Para evitar redundancias y los errores asociados, en la descripción de la función se trabaja con marcadores de posición .... Por lo general se enumeran todas las variantes con parámetros opcionales, así como una entrada adicional en la que solo se describe el objeto de configuración:
f1 = aFunction(x);
f2 = aFunction(x, y);
// Optionale Konfiguration für alle Varianten
fx = aFunction(..., { eigenschaft1: <typ>
                    , eigenschaft2: <typ>
                    });
Si el objeto de configuración es obligatorio en una variante, también se indica directamente en esa variante como marcador de posición.
f1 = bFunction(x, {...});    // Konfiguration verpflichtend
f2 = bFunction(x, y, z);     // Konfiguration optional
// Konfiguration für alle Varianten
fx = bFunction(..., { eigenschaft1: <typ>
                    , eigenschaft2: <typ>
                    });
Cada uso de una función en el texto de fórmulas se representa mediante una instancia propia, en la que, por ejemplo, pueden almacenarse estados o agregaciones de un ciclo de cálculo a otro. Ejemplos de ello son
- contadores
- sumadores, integradores
- filtros
- histéresis
- elementos lógicos con función de memoria
- funciones con referencia temporal
Las funciones se ejecutan por lo general, y generan un valor de salida, cuando existen valores válidos para todos los parámetros y al menos un parámetro lleva una nueva marca de tiempo. Además, algunas funciones también se ejecutan cuando se cumple una condición temporal (interna).
Determinadas funciones, como, p. ej., integrate() o stopwatch(), marcan sus datos de salida de modo que los cálculos posteriores también puedan interpolar linealmente entre dos puntos de datos concretos. Esto mejora la calidad del cálculo, ya que aquí se sabe que una señal de entrada constante conducirá a una señal de salida lineal.
Las funciones también pueden colocar valores de salida adicionales en el flujo de datos con independencia de las marcas de tiempo de los valores de los parámetros o del ciclo de procesamiento, p. ej. cuando al expirar un temporizador debe restablecerse una señal o cuando la propia función define la forma de la señal de salida. Ejemplos de ello son las funciones posedge() y negedge(), que al detectar un flanco escriben cada una un impulso con una duración de 1 nanosegundo en el flujo de datos de salida.
Configuración de las propiedades de las funciones
El comportamiento de determinadas funciones puede ajustarse, optimizarse o modificarse mediante propiedades. Estas propiedades se pasan a la función en un objeto de configuración {...} en la última posición de la lista de parámetros.
La sintaxis implementada admite, respecto al estándar JSON, algunas simplificaciones pero también ampliaciones útiles, para, por ejemplo, librar la representación JSON de la propiedad "math" de demasiadas secuencias de escape \:
- Los nombres de las propiedades o las etiquetas ENUM no tienen que ir entre comillas simples
- El uso de comillas
"..."y'...'para la asignación de cadenas es equivalente. - Para los valores numéricos enteros pueden utilizarse para la entrada todas las notaciones, como, p. ej.,
0x...o0.... - Algunas propiedades permiten, como alternativa a la indicación de un valor numérico, también determinadas etiquetas ENUM, para, por ejemplo, desactivar la función correspondiente (
'off') o establecerla en valores estándar ('def','auto', ...). - Se admiten comentarios en ambas notaciones
// ...y/* ... */ - Las propiedades que la función no conoce o no evalúa (p. ej. por una errata en el nombre) se ignoran y se notifican como WARNING con la lista de los nombres afectados1.
Para las propiedades están previstos los siguientes tipos:
| Tipo | Valores | Ejemplo |
|---|---|---|
<bool> | true, on, yes, 1 false, off, no, 0 | edge: yes |
<uint> | valores enteros positivos también en notación 0x- (hex) o 0- (octal) | range: 0x7F |
<int> | valores enteros con signo | min: -10 |
<dbl> | números de coma flotante (¡punto decimal!) también en notación exponencial 1.35e-22 | delay: 13.45 |
<time>2 | Números de coma flotante como intervalo de tiempo en segundos, con una extensión para poder introducir opcionalmente también minutos, horas o días enteros: [[[d:]h:]m:]s.fSe admite un signo1. | longPeriod: 9025.3longPeriod: 2:30:25.3longPeriod: 1:00:00:00 |
<date>2 | Números de coma flotante como marca de tiempo absoluta (segundos UTC desde el 01.01.1970), con una extensión para poder indicar opcionalmente también fecha+marca de tiempo UTC en formato ISO yyyy-mm-ddTHH:MM:SS.f.A partir de la versión 14 del catálogo también se admite una fecha sola yyyy-mm-dd (00:00 h), un espacio en lugar de T, los segundos son opcionales y una Z final identifica UTC1. | tBegin: 1770204975.256tBegin: 2026-02-04T11:36:15.256tBegin: '2026-02-04 11:36' |
<cxFlt> | número complejo de coma flotante | pole: (-5, 0.8) |
<str> | Cadena de caracteres / texto; las comillas solo son obligatorias si contiene espacios, comas o caracteres especiales. | storage: 'total_km' |
<var> | Variant, puede adoptar todos los tipos mencionados anteriormente | preset: 0x2F |
<enum> | Determinadas etiquetas enumeradas, véase la descripción de la función | mode: peakCenter |
off/<typ> | Alternativa entre etiquetas enum o un tipo regular <typ> | lower: off,upper: 12.6 |
[<typ>] | Vector separado por comas con datos de tipo <typ> | map: [1,2,4,8] |
Con ayuda de la palabra clave reservada $ref el contenido de la configuración puede obtenerse íntegramente de un recurso. Puede tratarse de una configuración en el formato JSON simplificado descrito anteriormente, pero también de un texto cualquiera o incluso de contenido binario, siempre que la función lo necesite y lo admita.
f = someConfigExpectingFunction({$ref:'someNamedResource'});
La configuración es constante, en principio, durante el tiempo de ejecución. No se permite calcular los valores de las propiedades. No es posible un enlace con variables del conjunto de fórmulas. Algunas funciones tienen para ello parámetros opcionales que permiten modificar también dinámicamente ajustes como, p. ej., valores límite.
Las propiedades indicadas en la documentación son opcionales, a menos que estén marcadas como obligatorias (mandatory).
Información de estado persistente
Determinadas funciones, que se utilizan preferentemente para la agregación de señales o eventos, pueden almacenar su estado interno a través de los canales persistentes de smartCORE y, tras un reinicio del software, partir del estado almacenado previamente y continuar el cálculo. Ejemplos de ello son
- contadores
- integradores
- clasificaciones
Para ello, en el área de la configuración JSON de la función correspondiente se indica el nombre de una ubicación de almacenamiento mediante la propiedad storage. El contenido de esta variable, creada y gestionada automáticamente, por lo general no puede ser interpretado por el usuario ni por otras unidades funcionales de smartCORE. No se permite utilizar el mismo almacenamiento en distintos puntos del texto de fórmulas.
Si en el almacenamiento se persiste un estado con relación a una magnitud física, se recomienda añadir al nombre un identificador de su unidad (p. ej. 'totalDistance_km') para facilitar la legibilidad y el posterior mantenimiento del texto de fórmulas.
Solo se puede acceder de nuevo al contenido del almacenamiento persistente a través de la misma función.
En el ejemplo siguiente se persiste un valor de contador:
f = someCounterFunction(someCondition, {storage:'some.counter.variable'});
Todos los datos persistidos se almacenan periódicamente como BLOB en una base de datos SQLite. Las entradas de esta base de datos no se eliminan automáticamente.