Référence du langage
Cette référence traite de la structure du jeu de formules.
Structure du jeu de formules
Un jeu de formules se compose d'une liste de termes reliés et terminés par le caractère ;, ainsi que, facultativement, de commentaires et de constructions de contrôle.
Steuerkonstrukt
Term 1;         // optionaler Kommentar
Term 2;
Term 3;         /* Beschreibung */
Termes
Un terme est
-
une valeur booléenne ou numérique constante ou une chaîne de caractères
Exemples :false,14,-23.5,"Hello" -
un nom de variable
Exemples :Speed,$"GPS.Location" -
un terme groupé par un opérateur de parenthèses
Exemples :(Term + Term) * Term,[Term, Term, Term], -
un terme modifié par un opérateur unaire
Exemples :! Term,- Term,~ Term -
une paire de termes reliés par un opérateur
Exemples :Term = Term,Term + Term,Term ? Term : Term -
une liste de termes reliés par des opérateurs
,Term, Term, Term, ... -
un appel de fonction
funktion(...) -
un objet de configuration délimité par
{...}.
L'objet de configuration suit une syntaxe propre, par exemple un codage JSON simplifié.
Les termes, opérateurs et fonctions sont traités exclusivement selon la disponibilité temporelle des données ; l'ordre dans lequel ils sont notés n'a aucune incidence sur le calcul.
Commentaires
Les commentaires - comme dans les langages de programmation C et C++ - commencent soit par // et se terminent alors automatiquement en fin de ligne, soit commencent par /* et se terminent par */. La notation /* ... */ peut être imbriquée, comme une expression entre parenthèses.
// Im Kommentar beginnt "-hier keine Zeichenkette und [-hier keine Matrix

s1 = "dies ist ein Text"; // ab hier Kommentar
s2 = "hier geht's gleich wieder weiter";

// Hilfreiche Markierung für komplexe Datenstrukturen
Tensor = [ /* Slice 1: */ [ [111, 112]
                          , [121, 122] ]
         , /* Slice 2: */ [ [211, 212]
                          , [221, 222] ]
         , /* Slice 3: */ [ [311, 312]
                          , [321, 322] ] ];

/* Dieser Abschnitt ist nur für die Inbetriebnahme
T1 = 12.34 * Tensor;
 */
La séquence de caractères // n'est pas prise en compte lorsqu'elle se trouve dans une chaîne de caractères délimitée par "..." ou '...' ou à l'intérieur d'un commentaire /* ... */. Dans l'exemple, les affectations à a et e ne sont donc pas interprétées, mais l'affectation à z l'est bien.
/* Im Block-Kommentar wird // ignoriert */
s1 = "Dies ist ein //-Text und weder ein Kommentar noch eine Formel: 1+1";
/*
a = b + c;
e = f * g;
// */  z = b / g;
Les marques de début et de fin de commentaire /*...*/ ne sont chacune pas prises en compte lorsqu'elles sont notées après un // « visible ». Dans l'exemple, le bloc de commentaire est maintenant lui-même mis en commentaire ; les affectations à a et e sont exécutées, mais plus l'affectation à z.
// Im Zeilen-Kommentar werden /* und */ ignoriert
// /*
a = b + c;
e = f * g;
// */ z = b / g;
Si un commentaire de bloc /*...*/ ouvert n'est pas fermé, une erreur est affichée.
Constructions de contrôle
Les constructions de contrôle commencent en début de ligne par un caractère # et s'étendent jusqu'à la fin de ligne suivante qui n'est pas masquée dans un niveau de parenthésage. La structure d'une construction de contrôle suit, selon sa fonction, une syntaxe définie en conséquence. Des commentaires peuvent être insérés.
#controlA <parameter>
#controlB <name>[<parameter>](<parameter>){<code>}
#controlC <key>, <key>=<value>, …
Les constructions de contrôle permettent d'influencer des fonctions du compilateur du module Math, le traitement des variables et l'exécution du code.
Une construction de contrôle peut ainsi avoir des effets sur les termes notés à sa suite.
Les constructions de contrôle sont rassemblées dans ce document.
Mise en œuvre de la fonctionnalité souhaitée
Boîte à outils
Pour la mise en œuvre de la fonctionnalité souhaitée, des fonctions et opérateurs sont disponibles dans les catégories suivantes :
- opérateurs arithmétiques et logiques
- fonctions mathématiques et trigonométriques
- fonctions de filtrage temporel (comme p. ex. la différentiation et l'intégration de fonctions)
- algorithmes numériques (p. ex. FFT, décomposition de matrices, interpolation, prédiction)
- échantillonnage (sampling) de données de mesure
- fonctions de comptage et temporisateurs
- fonctions de sélection, fonctions orientées bits ainsi que fonctions de conversion de types de données (casts)
- la prise en charge de séquences d'expressions et d'affectations
- fonctions de texte (chaînes de caractères)
Au fil du développement du module Math, de nouvelles fonctions sont régulièrement ajoutées et des erreurs de fonctions existantes sont bien sûr corrigées. Selon la version de smartCORE déployée, un état de version déterminé est disponible. Celui-ci est également affiché dans le fichier journal sous la forme d'un numéro de catalogue continu, V11 dans l'exemple :
...|...|...|INFO   |module.math:  (II)  "Welcome to mathExpression library, git '0ed7f17-dirty', build 'Feb  2 2026 15:30:55'"
...|...|...|INFO   |module.math:  (II)  "Package 'mathExpCore', V11 (using V11)"
Exécution conditionnelle, boucles
En raison du traitement continu de données horodatées en flux, chaque terme doit être compris comme un composant électrique ou un filtre dans un circuit électrique. L'implémentation de constructions de contrôle classiques, qui influencent le déroulement du texte de formule, perd ainsi tout son sens. C'est pourquoi les éléments de langage suivants, ou leurs variantes, ne se trouvent pas dans le module de calcul :
- IF-THEN-ELSE
- WHILE-DO
- REPEAT-UNTIL
- FOR-TO-DO, FOR-EACH
- SWITCH-CASE
Il existe toutefois diverses fonctions permettant, par exemple, de sélectionner parmi différentes sources de signaux. Cela correspondrait à un relais ou à un multiplexeur en électronique.
D'autres fonctions permettent de mémoriser des valeurs à un instant donné ou de détecter des changements de valeur ou des fronts.
Pour des raisons similaires, il n'existe pour l'instant aucune implémentation de procédures ou de fonctions définies par l'utilisateur.
Calcul à temps exact
Tous les termes, opérateurs et fonctions traitent et produisent toujours des données horodatées, typiques du smartCORE. Ces données sont combinées entre elles à temps exact, une valeur de sortie étant en règle générale calculée pour chaque horodatage d'entrée des flux de données impliqués dans un terme. Le tracé du signal entre deux horodatages est alors supposé constant (bloqueur d'ordre 0) par rapport à la valeur la plus ancienne dans l'intervalle de temps, c'est-à-dire que la valeur la plus ancienne est valable jusqu'à l'horodatage de la valeur la plus récente. Un traitement ultérieur des données ne peut donc avoir lieu que si, à un instant donné, toutes les valeurs d'entrée impliquées du terme possèdent également des valeurs valides. La plage de temps valide pour le calcul se termine, pour un flux de données, à son horodatage le plus récent. Le tableau suivant montre un exemple pour deux sources de données horodatées A et B et un calcul :
| Instant | A | B | A + B |
|---|---|---|---|
| 1 | (non défini) | 10 | (non défini) |
| 2 | 5 | 15 | |
| 3 | 20 | 25 | |
| 5 | 30 | 35 | |
| 8 | 8 | 38 | |
| 13 | 9 | 40 | 49 |
| 26 | 5 | 45 | |
| 27 | 2 | 42 | |
| 30 | (en attente) | 50 | (en attente) |
Cela signifie directement que, pour des données qui ne sont fournies que rarement ou qui ne sont plus du tout fournies, par exemple à la suite de l'arrêt d'un composant du système, tous les calculs qui en dépendent ne sont d'abord traités que jusqu'à cet horodatage le plus récent, puis y sont bloqués. Le module Math offre diverses possibilités pour atténuer ces situations de blocage.
Le paramètre evaluationTimeMs définit uniquement l'intervalle de temps en ms dans lequel l'interpréteur traite, pour tous les termes, tous les points de données disponibles à cet instant (traitement par lots, batch processing). Cela s'accompagne d'une certaine « puissance réactive ». C'est pourquoi l'intervalle doit être choisi au moins assez long pour que des données puissent être traitées à chaque cycle, mais de préférence aussi assez court pour que le nombre de points de données individuels reste dans une limite raisonnable (env. < 100). Si l'on ne dispose par exemple que de sources de données qui fournissent de nouvelles valeurs toutes les 2 secondes, on pourrait régler evaluationTimeMs sur 5000 ms. Pour des sources de données qui fournissent leurs points de données à 1 kHz, un evaluationTimeMs de 100 ms est plus judicieux. Un temps de cycle plus court est également judicieux lorsque les résultats du jeu de formules doivent servir à réaliser des tâches de commande dans le processus.
Grâce au traitement des données à temps exact, l'ordre des expressions dans le jeu de formules n'a en définitive aucune importance. Pour des raisons de lisibilité, il est toutefois recommandé de n'utiliser que des variables qui ont été affectées auparavant.
Calcul à temps discret
Le calcul à temps exact ne peut pas être réalisé lorsque des variables sont ramenées sur elles-mêmes par une référence circulaire. Un exemple d'une telle construction est l'implémentation d'un simple algorithme de filtrage pondéré :
y_out = weight * y_out + (1 - weight) * x_in;
Selon la règle introduite précédemment, y_out est recalculé pour tous les instants définis par les données d'entrée weight, y_out et x_in. Tandis que weight et x_in sont soit définis indépendamment comme constants (donc toujours valides), soit prolongés à partir d'un signal de mesure, y_out n'est d'abord pas du tout renseigné. Qu'est-ce qui définit la première valeur de y_out ? Et si celle-ci est posée avec un horodatage, y_out ne peut être calculé au maximum que jusqu'à cet horodatage précis - donc pas du tout, car cet instant est déjà affecté.
En régulation et en commande, ainsi que dans les langages de programmation, on interprète toutefois l'expression ci-dessus de telle sorte que la « nouvelle » valeur de y_out résulte de l'« ancienne » valeur de y_out selon la formule. La « nouvelle » valeur de y_out se situe alors un pas d'échantillonnage dans le futur, de sorte que le calcul suivant peut être exécuté en conséquence.
Le module Math détecte les références circulaires (même indirectes) et fait passer les variables concernées à une règle de calcul discrète. Les variables avancent alors selon un intervalle de temps et une trame fixes, déterminés par le paramètre discreteSampleTimeMs. Tous les calculs discrets sont cadencés sur cette trame.
Pour résoudre la question de la valeur initiale, une syntaxe spéciale, qui n'est exécutée qu'une seule fois, est définie : pour l'affectation de la valeur de départ, le suffixe @0 est ajouté à la variable :
y_out@0 = x_in;
y_out   = weight * y_out + (1 - weight) * x_in;
Dans cet exemple, la première valeur disponible sur la variable d'entrée x_in est utilisée comme valeur de départ au point de trame immédiatement suivant pour y_out. À partir de ce moment, le calcul et l'affectation de y_out s'exécutent selon l'intervalle de temps fixe et aligné.
En raison de l'échantillonnage, des variations rapides du signal situées entre deux instants d'échantillonnage peuvent être perdues. catch(x, {...}) peut être utilisé pour prendre en compte des composantes de signal critiques, plus rapides, de l'intervalle.
Identifiants et variables
Les conventions suivantes s'appliquent aux noms de variables (signaux, canaux)
- le premier caractère doit appartenir au groupe a-z, A-Z ou _
- tous les caractères suivants doivent appartenir au groupe a-z, A-Z, 0-9 ou _
- la casse est prise en compte
- tous les caractères non mentionnés, comme p. ex. les voyelles infléchies (tréma), les caractères spéciaux, les parenthèses, les symboles mathématiques, les espaces, ne sont pas autorisés !
Tous les identifiants sont sensibles à la casse (case-sensitive), c'est-à-dire que "varIABLE", "Variable" et "VARiable" sont trois identifiants différents.
Il est possible d'inclure dans le calcul les données de canaux smartCORE existants en indiquant le nom du canal. S'il faut pour cela accéder à des canaux smartCORE dont le nom enfreint la règle précédente, il existe une possibilité au moyen des notations suivantes
$'Some + strange.å =channel ů /name!'
$"Some + strange.å =channel ů /name!"
Il en va de même pour les canaux qui doivent être restitués au smartCORE et qui nécessitent une dénomination particulière.
Une variable ne peut faire l'objet d'une affectation qu'à un seul endroit précis. Les variables sans affectation locale sont recherchées comme source de données dans le contexte du smartCORE. Cela vaut également pour les variables qui représentent des sorties secondaires d'un bloc fonctionnel et qui sont définies avec les propriétés.
Constantes
Les identifiants suivants sont disponibles comme constantes dans le contexte du texte de formule :
| Identifiant | Valeur | Type |
|---|---|---|
| true | true | <bool> |
| on | true | <bool> |
| yes | true | <bool> |
| high | true | <bool> |
| false | false | <bool> |
| off | false | <bool> |
| no | false | <bool> |
| low | false | <bool> |
| pi | <dbl> | |
| magic | <uint> | |
| j | <cxFlt> |
S'il existe dans le smartCORE des variables portant l'un de ces noms, la notation spéciale pour les variables $'…' (voir Identifiants) permet de garantir la distinction. Par ailleurs, l'utilisation de l'identifiant comme constante a la priorité.
Types de données et conversion de type
Types de données
Le module Math choisit pour chaque calcul un type de données approprié afin de pouvoir exécuter les opérations souhaitées avec la meilleure représentation possible. Les types sont les suivants
| Type de données | Désignation | Description | Longueur en bits | Minimum | Maximum |
|---|---|---|---|---|---|
| boolean | <bool> | Valeur de vérité | 1 | false, no, off, low | true, on, yes, high |
| unsigned integer | <uint> | Entier non signé | 64 | 0 | 18446744073709551615 |
| integer | <int> | Entier signé | 64 | -9223372036854775808 | +9223372036854775807 |
| Plus petite résolution | Plage de valeurs | ||||
| double | <dbl> | Nombre à virgule flottante en double précision | 64 | ±5.0E-324 | ±1.7976931348623157E+308 |
| complex float | <cxFlt> | nombre à virgule flottante complexe en simple précision (*) | 2x 32 | ±1.175494E-38 par composante Re/Im | ±3.402823E+38 par composante Re/Im |
| string | <str> | Texte, UTF-8 | N/A | N/A | N/A |
En règle générale, il n'est pas nécessaire de se préoccuper du type ; lors de la transmission au smartCORE, la conversion vers le type de données indiqué à cet effet est effectuée de manière appropriée.
Dans cette description des fonctions, le type de données est généralement placé entre chevrons, donc p. ex. <bool> ou <str>.
Conversion de type automatique
Lors du traitement de données numériques au moyen d'opérateurs binaires, la conversion de type automatique suivante est effectuée en fonction des types des opérandes
| bool | uint | int | dbl | cxFlt | str | |
|---|---|---|---|---|---|---|
| bool | bool | uint | int | dbl | cxFlt | str |
| uint | uint | uint | int | dbl | cxFlt | str |
| int | int | int | int | dbl | cxFlt | str |
| dbl | dbl | dbl | dbl | dbl | cxFlt | str |
| cxFlt | cxFlt | cxFlt | cxFlt | cxFlt | cxFlt | str |
| str | str | str | str | str | str | str |
Ainsi, aussi longtemps que possible, sont conservés
- les valeurs booléennes également uniquement true/false
- les propriétés des valeurs uint pour les opérations sur bits
- le signe lors de l'utilisation de valeurs int
- la précision des nombres à virgule flottante
- l'espace des nombres complexes reste disponible
Particularités pour bool
-
Lors de la conversion vers
<bool>, la comparaison différent de 0 s'applique implicitement pour obtenir la valeur de vérité. -
Lors de la conversion de
<bool>vers un type numérique, false devient 0 et true devient 1. -
Lors de l'addition de deux valeurs booléennes, la conversion se fait vers
<uint>. -
Lors de la soustraction de deux valeurs booléennes, la conversion se fait vers
<int>. -
Lors du calcul sur des champs de données de type
<bool>, le résultat est toujours<int>.
Particularités pour uint
-
Lors de la soustraction de deux valeurs non signées
<uint>-<uint>, le résultat est<int>si le deuxième opérande est supérieur au premier. On évite ainsi le dépassement, le plus souvent totalement absurde et non voulu, de l'ordre de 2^64. -
Lors du calcul sur des champs de données de type
<uint>, le résultat est toujours<int>.
Conversion de type manuelle
Il est également possible d'effectuer une conversion de type manuelle à l'aide des fonctions suivantes
| Fonction | Description |
|---|---|
bool(x) | Conversion de l'argument x en bool |
uint(x) | Conversion de l'argument x en uint |
int(x) | Conversion de l'argument x en int |
dbl(x) | Conversion de l'argument x en double |
str(x) | Conversion de l'argument x en string |
Types numériques
Directement dans le texte de formule et dans les objets de configuration pour les propriétés des fonctions, les valeurs numériques peuvent également être indiquées dans différents systèmes de numération. Exemples de notations :
  aBool         = true;         // alt.: false, on, off, yes, no, high, low
  anUnsignedInt = 42;           // alt.: 42u
  aHexUInt      = 0x2A;         // alt.: 2Ah
  anOctUInt     = 052;          // alt.: 52o
  aBinUInt      = 0b10'1010;    // alt.: 101010b
  aSignedInt    = -42;
  aDouble       = 3.14159;      // alt.: 1.6022e–19, pi, !! decimal-point
  aComplex      = 2.7+1.0*j;    // alt.: cx(2.7, 1.0)
Séparateur de groupes
Pour les entiers non signés (<uint>) ou signés (<int>), les chiffres individuels peuvent être répartis en groupes en insérant une apostrophe simple '. Ce caractère n'a aucune incidence sur l'interprétation de la valeur numérique, mais facilite la lecture. Il ne doit pas se trouver au début ou à la fin d'un nombre.
aHexUInt      = FFe7'0815'337Eh;    // 0815 ist hier kein String!
aBinUInt      = 0b1011'0110'1010;
aLargeInt     = 1'000'000'000;
Signe et négation
En faisant précéder un opérateur -, la valeur négative est formée pour chaque format numérique (complément à 2).
Faire précéder un opérateur + est autorisé, mais sans effet.
L'opérateur ~ inverse l'entier au niveau des bits d'un <uint> (exemple : ~0b1010'0011'1100 -> 0b1111...1111'0101'1100'0011).
Format numérique hexadécimal
La représentation d'un nombre dans le système hexadécimal (base 16) s'effectue soit en faisant précéder 0x ou 0X, soit en ajoutant la lettre h. Les chiffres possibles sont 0 .. 9, a .. f ou A .. F ainsi que le séparateur de groupes.
L'indication d'un nombre dans le système hexadécimal est toujours interprétée comme non signée, mais peut être niée par l'opérateur - ou inversée par ~.
Format numérique octal
La représentation d'un nombre dans le système octal (base 8) s'effectue soit en faisant précéder un 0 (zéro), soit en ajoutant la lettre o. Les chiffres possibles sont 0 .. 7 ainsi que le séparateur de groupes.
L'indication d'un nombre dans le système octal est toujours interprétée comme non signée, mais peut être niée par l'opérateur - ou inversée par ~.
Format numérique binaire
La représentation d'un nombre dans le système binaire (base 2) s'effectue soit en faisant précéder 0b ou 0B, soit en ajoutant la lettre b. Les chiffres possibles sont 0 .. 1 ainsi que le séparateur de groupes.
L'indication d'un nombre dans le système binaire est toujours interprétée comme non signée, mais peut être niée par l'opérateur - ou inversée par ~..
Chaînes de caractères (littéraux de chaîne)
Les chaînes de caractères constantes sont encadrées par des guillemets simples ' ou doubles ". Si une chaîne de caractères contient elle-même un ' ou un ", celui-ci doit être marqué en le faisant précéder du caractère d'échappement \. Exemples :
s1a = '17" (inch)';
s1b = "17\" (inch)";
s2a = "Hat's funktioniert?";
s2b = 'Hat\'s funktioniert?';
De manière générale, les caractères spéciaux dans les chaînes de caractères, utilisés par exemple pour les expressions régulières lors de la recherche de texte ou pour l'interprétation ou la génération de protocoles série d'appareils, peuvent être représentés par les séquences d'échappement suivantes :
| Caractère | Nom ASCII | Valeur ASCII | Séquence d'échappement |
|---|---|---|---|
| Newline (Linefeed) | NL (LF) | 10 | \n |
| Horizontal tab | HT | 9 | \t |
| Vertical tab | VT | 11 | \v |
| Backspace | BS | 8 | \b |
| Carriage return | CR | 13 | \r |
| Formfeed | FF | 12 | \f |
| Alert | BEL | 7 | \a |
| Escape | ESC | 27 | \e |
| Backslash | \ | 92 | \\ |
| Question mark | ? | 63 | \? |
| Single quotation mark | ' | 39 | \' |
| Double quotation mark | " | 34 | \" |
| Character from octal code | NNN = 000 .. 377 (octal digits) | \oNNN\o{N...} | |
| Character from decimal code | NNN = 000 .. 255 (decimal digits) | \dNNN\d{N...} | |
| Character from hex code | NN = 00 .. FF (hex digits) | \xNN\x{N...} | |
| UTF characer(s) from decimal code | UTF8-Multibyte | NNNN = x0000 .. xFFFF x00000000 .. x0010FFFF | \uNNNN\UNNNNNNNN\u{N...} |
Le codage des caractères s'effectue en interne toujours en UTF-8 (UTF-8 – Wikipédia).
Opérateurs arithmétiques et logiques
Cette section traite des opérateurs arithmétiques et logiques, y compris leur rang et leur associativité.
Associativité
Nous appelons un opérateur ° associatif à gauche lorsque ce qui suit s'applique
a ° b ° c = (a ° b) ° c
et, de façon correspondante, associatif à droite lorsque l'on a
a ° b ° c = a ° (b ° c)
Un opérateur * a un rang plus élevé (priorité, force de liaison) que l'opérateur + lorsque, indépendamment des associativités des deux opérateurs, on a
a + b * c = a + (b * c)
Lorsque la liaison entre des termes n'est pas immédiatement évidente, il est recommandé de forcer l'ordre d'évaluation voulu par un usage généreux de (...). En particulier pour les opérateurs logiques ou de comparaison, la priorité n'est pas toujours familière. Pour les expressions complexes, il est en outre recommandé d'utiliser plusieurs lignes consécutives et un alignement approprié des termes pour la structuration.
res = A && (B || (C && D) || (E && (F || G)));    // Variante 1
opt = A && (    B                  // optionaler Kommentar
            || (C && D)            // optionaler Kommentar
            || (E && (   F         // optionaler Kommentar
                      || G)        // optionaler Kommentar
               )
           );                                    // Variante 2
Opérateurs
Le tableau suivant contient les opérateurs disponibles, triés par priorité croissante. Tous les opérateurs listés ici travaillent sur les types de données introduits précédemment. Des fonctions propres sont disponibles pour les combinaisons logiques et opérations orientées bits.
| Opérateur | Affectation | Associativité | Description | Exemple | Type de résultat |
|---|---|---|---|---|---|
| ; | gauche | séquence d'instructions exécutée indépendamment du temps | y = 7; x = 4 | void | |
| , | gauche | enchaînement d'expressions individuelles | a = 4, b = 6, a + b | comme la dernière expression | |
| += | OUI | droite | affectation composée relative à l'addition | a += 17 | automatique |
| -= | OUI | droite | affectation composée relative à la soustraction | a -= b | automatique |
| *= | OUI | droite | affectation composée relative à la multiplication | a *= b | automatique |
| /= | OUI | droite | affectation composée relative à la division | a *= b | automatique |
| %= | OUI | droite | affectation composée relative au modulo | b %= 4 | automatique |
| = | OUI | droite | Affectation | a = 23 * b | comme l'expression affectée |
| ? : | droite | opérateur ternaire if-else | (a > 23) ? 12 : -50 | comme le corps résultant | |
| || | gauche | disjonction logique (OR) | a || b | <bool> | |
| && | gauche | conjonction logique (AND) | a && b | <bool> | |
| ^^ | gauche | antivalence logique (XOR) | a ^^ b | <bool> | |
| == | gauche | Égalité | a == b | <bool> | |
| != | gauche | Inégalité | a != b | <bool> | |
< | gauche | inférieur à | a < b | <bool> | |
<= | gauche | inférieur ou égal | a <= b | <bool> | |
> | gauche | supérieur à | a > b | <bool> | |
>= | gauche | supérieur ou égal | a >= b | <bool> | |
| + | gauche | Addition | a + b | automatique | |
| - | gauche | Soustraction | a - b | automatique | |
| * | gauche | Multiplication | a * b | automatique | |
| / | gauche | Division | a / b | automatique | |
| % | gauche | Modulo | a % b | automatique | |
| ^ | droite | Élévation à la puissance | a ^ 0.333 | <dbl> | |
| ! | droite | inversion logique (NOT) | !(a && b) | <bool> | |
| ~ | droite | inversion orientée bits | ~a | <uint> | |
| + | droite | signe positif | 6 / +a | automatique | |
| - | droite | signe négatif | 9 * -a | automatique |
Opérateurs d'affectation
Une variable ne peut faire l'objet d'une affectation qu'à un seul et unique endroit du texte de formule. Les variables sans affectation locale sont recherchées comme source de données dans le contexte du smartCORE.
Pour les opérateurs d'affectation, il doit impérativement y avoir du côté gauche une variable (x, y, …), un élément d'une matrice déjà affectée auparavant (V[2], M[0,2], …) ou l'initialiseur d'une variable échantillonnée de manière discrète (k@0, …), dans laquelle le résultat est stocké. Le résultat de l'expression reste la valeur affectée. Cela rend également possible l'enchaînement d'affectations ou l'utilisation d'une affectation à l'intérieur d'une expression.
Opérateurs pour champs de données
Lorsque les opérateurs +, -, * et / sont appliqués à des champs de données (vecteurs, matrices, tenseurs), les règles usuelles en mathématiques concernant la dimension des opérandes et la dimension qui en résulte pour le résultat s'appliquent. Les règles suivantes s'appliquent :
-
Pour l'addition et la soustraction, les champs de données concernés doivent avoir la même dimension. L'opération s'effectue à chaque fois sur les éléments de mêmes indices.
-
Un champ de données peut être multiplié à volonté par un scalaire :
DF * sous * DF. L'opération est exécutée pour chaque élément. -
Un champ de données ne peut être divisé que par un scalaire :
DF / sL'opération est exécutée pour chaque élément. -
Pour la multiplication, le premier champ de données doit avoir autant de colonnes que le second champ de données a de lignes. Le résultat contient autant de lignes que le premier champ de données et autant de colonnes que le second champ de données.
Comme, pour les vecteurs, on ne distingue pas explicitement ici entre vecteur ligne et vecteur colonne, les règles suivantes s'appliquent :-
Le produit de deux vecteurs de même longueur est toujours le produit scalaire.
-
Pour le produit vectoriel de vecteurs à 2 et 3 composantes, il faut utiliser la fonction
Cross(v1, v2). -
Le produit d'un vecteur et d'une matrice lit le vecteur comme un vecteur ligne.
-
Le produit d'une matrice et d'un vecteur lit le vecteur comme un vecteur colonne.
-
Égalité de champs de données
Deux champs de données sont égaux si et seulement s'ils concordent exactement par le type de données, la dimension et tous les éléments. Aucune conversion de type automatique n'a lieu avant la comparaison. Deux champs de données sont différents s'ils ne sont pas égaux au sens de la définition précédente.
Les autres comparaisons ne sont pas disponibles.
Parenthèses
Les paires de parenthèses suivantes sont également reconnues dans les expressions imbriquées. Chaque parenthèse ouvrante doit être correctement fermée dans le bon ordre.
| Parenthésage | Signification | Exemple |
|---|---|---|
( ... ) | Regroupement dans l'ordre d'évaluation, regroupement de paramètres de fonction | (a+b)/2, max(a, b, 50) |
[ ... ] | Réservé à la représentation de vecteurs, matrices et tenseurs et à l'indexation de variables ; l'indexation compte toujours de 0…(N-1), pour les vecteurs : V[<idx>], on ne distingue pas vecteur ligne/colonnepour les matrices : M[<row>, <col>] pour les tenseurs : T[<slice>,<row>, <col>] | a = [1, 2, 3], b = [[1.1, 1.2], [2.1, 2.2]], a[1] + b[0,1] |
{ ... } | - Parenthésage pour les objets JSON pouvant servir au paramétrage de blocs fonctionnels. Comme ceux-ci peuvent devenir très volumineux, il est recommandé de renvoyer, par un lien $ref: '<path>', à une ressource JSON externe, rassemblée dans un conteneur distinct du module de calcul. | timer({ interval: 60 }) |
? ... : | L'expression entre ? et : est implicitement entourée de (…). |
Fonctions
Les fonctions du module Math sont fournies par le plug-in lui-même et, à l'avenir, également par d'autres plug-ins thématiques pour le module Math ; elles sont en principe implémentées en C++.
Appel de fonction
Chaque fonction se compose d'un nom de fonction, qui suit la syntaxe usuelle des identifiants
- le premier caractère appartient au groupe a-z, A-Z ou _
- tous les caractères suivants appartiennent au groupe a-z, A-Z, 0-9 ou _
- la casse est prise en compte
suivi d'une liste de paramètres qui contient, dans ( ... ), une liste de termes individuels séparés par des virgules.
Dans la description de blocs fonctionnels complexes, les paramètres de la fonction sont également appelés entrées et la valeur de retour de la fonction sortie.
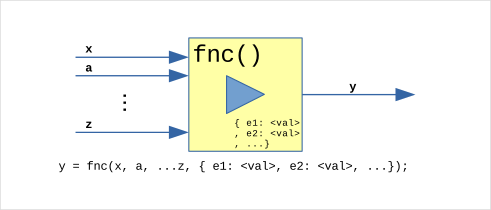
Des identifiants d'espaces de noms peuvent être placés devant le nom de la fonction au moyen d'un '.'. Par ailleurs, les identifiants d'espaces de noms suivent les mêmes règles.
Exemples d'appels de fonction
   f1  = functionNoParam();
   f2  = functionOneParam(x);
   f3a = functionOptionalParam(x,a);
   f3b = functionOptionalParam(x,a,b);
   f3c = functionOptionalParam(x,a,b,c);
   f4  = functionWithConfig(x,y,z, {...});
Pour les paramètres, on distingue les paramètres obligatoires et facultatifs (entrées), ainsi qu'un objet de configuration pour les propriétés de la fonction comme dernier élément. La signification des paramètres peut varier avec le nombre de paramètres utilisés ; il faut se reporter pour cela à la description de la fonction.
Afin d'éviter les redondances et les erreurs qui en découlent, la description de la fonction travaille avec des espaces réservés .... En règle générale, toutes les variantes avec paramètres facultatifs sont listées, ainsi qu'une entrée supplémentaire dans laquelle seul l'objet de configuration est décrit :
f1 = aFunction(x);
f2 = aFunction(x, y);
// Optionale Konfiguration für alle Varianten
fx = aFunction(..., { eigenschaft1: <typ>
                    , eigenschaft2: <typ>
                    });
Si l'objet de configuration est obligatoire dans une variante, il est directement indiqué dans cette variante également comme espace réservé.
f1 = bFunction(x, {...});    // Konfiguration verpflichtend
f2 = bFunction(x, y, z);     // Konfiguration optional
// Konfiguration für alle Varianten
fx = bFunction(..., { eigenschaft1: <typ>
                    , eigenschaft2: <typ>
                    });
Chaque utilisation d'une fonction dans le texte de formule est représentée par une instance propre, dans laquelle peuvent être mémorisés, d'un cycle de calcul à l'autre, par exemple des états ou des agrégations. En voici des exemples
- Compteurs
- Sommateurs, intégrateurs
- Filtres
- Hystérésis
- Éléments logiques avec fonction de mémoire
- Fonctions avec référence temporelle
Les fonctions sont en règle générale exécutées et produisent une valeur de sortie lorsque tous les paramètres ont des valeurs valides et qu'au moins un paramètre porte un nouvel horodatage. En outre, certaines fonctions sont également exécutées lorsqu'une condition de temps (interne) est remplie.
Certaines fonctions, comme p. ex. integrate() ou stopwatch(), marquent leurs données de sortie de telle sorte que les calculs suivants puissent aussi interpoler linéairement entre deux points de données concrets. Cela améliore la qualité du calcul, car on sait ici qu'un signal d'entrée constant conduira à un signal de sortie linéaire.
Les fonctions peuvent également placer des valeurs de sortie supplémentaires dans le flux de données indépendamment des horodatages des valeurs de paramètres ou du cycle de traitement, p. ex. lorsqu'un signal doit être remis à zéro à l'expiration d'un temporisateur ou lorsque la forme du signal de sortie est définie par la fonction elle-même. Les fonctions posedge() et negedge() en sont des exemples : lors de la détection d'un front, elles écrivent chacune dans le flux de données de sortie une impulsion d'une durée de 1 nanoseconde.
Configuration des propriétés de fonction
Le comportement de certaines fonctions peut être réglé, optimisé ou modifié par des propriétés. Ces propriétés sont transmises à la fonction dans un objet de configuration {...} en dernière position de la liste de paramètres.
La syntaxe implémentée autorise, par rapport au standard JSON, quelques simplifications mais aussi des extensions utiles, afin par exemple de débarrasser la représentation JSON dans la propriété "math" d'un trop grand nombre de séquences d'échappement \ :
- Les noms des propriétés ou les tags ENUM n'ont pas besoin d'être placés entre guillemets
- L'utilisation de guillemets
"..."et'...'pour l'affectation de chaînes est équivalente. - Pour les valeurs numériques entières, toutes les notations, comme p. ex.
0x...ou0..., peuvent être utilisées pour la saisie. - Certaines propriétés autorisent, comme alternative à l'indication d'une valeur numérique, également certains tags ENUM, par exemple pour désactiver la fonction correspondante (
'off') ou la régler sur des valeurs par défaut ('def','auto', ...) - Les commentaires dans les deux notations
// ...et/* ... */sont autorisés
Les types suivants sont prévus pour les propriétés :
| Type | Valeurs | Exemple |
|---|---|---|
<bool> | true, on, yes, 1 false, off, no, 0 | edge: yes |
<uint> | valeurs entières positives également en notation 0x- (hex) ou 0- (octal) | range: 0x7F |
<int> | valeurs entières signées | min: -10 |
<dbl> | nombres à virgule flottante (point décimal !) également en notation exponentielle 1.35e-22 | delay: 13.45 |
<time>1 | nombres à virgule flottante comme intervalle de temps en secondes, avec une extension permettant de saisir facultativement aussi des minutes, heures ou jours entiers. | longPeriod: 9025.3longPeriod: 2:30:25.3 |
<date>1 | nombres à virgule flottante comme horodatage absolu (secondes UTC depuis le 01.01.1970), avec une extension permettant d'indiquer facultativement aussi la date et l'heure UTC au format ISO. | tBegin: 1770204975.256 tBegin: 2026-02-04T11:36:15.256 |
<cxFlt> | nombre à virgule flottante complexe | pole: (-5, 0.8) |
<str> | chaîne de caractères / texte, guillemets obligatoires uniquement si elle contient des espaces, des virgules ou des caractères spéciaux. | storage: 'total_km' |
<var> | Variant, peut prendre tous les types mentionnés précédemment | preset: 0x2F |
<enum> | Certains tags énumérés, voir la description de la fonction | mode: peak2 |
off/<typ> | Alternative composée de tags enum ou d'un type régulier <typ> | lower: off,upper: 12.6 |
[<typ>] | Vecteur séparé par des virgules contenant des données de type <typ> | map: [1,2,4,8] |
À l'aide du mot-clé réservé $ref, le contenu de la configuration peut être intégralement obtenu à partir d'une ressource. Il peut s'agir d'une configuration au format JSON simplifié décrit précédemment, mais aussi d'un texte quelconque ou même d'un contenu binaire, pour autant que la fonction en ait besoin et le prenne en charge.
f = someConfigExpectingFunction({$ref:'someNamedResource'});
La configuration est en principe constante pendant l'exécution. Un calcul des valeurs de propriétés n'est pas autorisé. Un lien avec des variables du jeu de formules n'est pas possible. Certaines fonctions disposent pour cela de paramètres facultatifs permettant de modifier aussi dynamiquement des réglages tels que des valeurs limites.
Les propriétés énumérées dans la documentation sont facultatives, sauf si elles sont signalées comme obligatoires (mandatory).
Informations d'état persistantes
Certaines fonctions, utilisées de préférence pour l'agrégation de signaux ou d'événements, peuvent enregistrer leur état interne via les canaux persistants du smartCORE et, après un redémarrage du logiciel, repartir de l'état précédemment enregistré et poursuivre le calcul. En voici des exemples
- Compteurs
- Intégrateurs
- Classifications
Pour cela, le nom d'un emplacement de stockage est indiqué dans la partie configuration JSON de la fonction correspondante au moyen de la propriété storage. Le contenu de cette variable, créée et gérée automatiquement, n'est en règle générale pas interprétable par l'utilisateur ou par d'autres unités fonctionnelles du smartCORE. L'utilisation du même stockage à différents endroits du texte de formule n'est pas autorisée.
Si un état en rapport avec une grandeur physique est rendu persistant dans le stockage, il est recommandé d'ajouter au nom un identifiant de son unité (p. ex. 'totalDistance_km'), afin de faciliter la lisibilité et la maintenance ultérieure du texte de formule.
Le contenu du stockage persistant n'est accessible que par la même fonction.
Dans l'exemple suivant, un état de compteur est rendu persistant :
f = someCounterFunction(someCondition, {storage:'some.counter.variable'});
Toutes les données persistantes sont enregistrées périodiquement sous forme de BLOB dans une base de données SQLite. Les entrées de cette base de données ne sont pas supprimées automatiquement.