Riferimento del linguaggio
In questo riferimento viene illustrata la struttura del set di formule.
Struttura del set di formule
Un set di formule è costituito da un elenco di termini collegati e conclusi tramite il carattere ;, nonché, opzionalmente, da commenti e costrutti di controllo.
Steuerkonstrukt
Term 1;         // optionaler Kommentar
Term 2;
Term 3;         /* Beschreibung */
Termini
Un termine è
-
un valore costante booleano o numerico oppure una stringa
Esempi:false,14,-23.5,"Hello" -
un nome di variabile
Esempi:Speed,$"GPS.Location" -
un termine raggruppato da un operatore di parentesi
Esempi:(Term + Term) * Term,[Term, Term, Term], -
un termine modificato da un operatore unario
Esempi:! Term,- Term,~ Term -
una coppia di termini collegati da un operatore
Esempi:Term = Term,Term + Term,Term ? Term : Term -
un elenco di termini collegati da operatori
,Term, Term, Term, ... -
una chiamata di funzione
funktion(...) -
un oggetto di configurazione delimitato da
{...}.
L'oggetto di configurazione segue una propria sintassi, ad es. una codifica JSON semplificata.
Termini, operatori e funzioni vengono elaborati esclusivamente in base alla disponibilità temporale dei dati; l'ordine in cui sono scritti non ha alcun ruolo per il calcolo.
Commenti
I commenti iniziano - come nei linguaggi di programmazione C e C++ - con // e terminano automaticamente alla fine della riga, oppure iniziano con /* e terminano con */. La notazione /* ... */ può essere applicata in forma annidata, come per un'espressione tra parentesi.
// Im Kommentar beginnt "-hier keine Zeichenkette und [-hier keine Matrix

s1 = "dies ist ein Text"; // ab hier Kommentar
s2 = "hier geht's gleich wieder weiter";

// Hilfreiche Markierung für komplexe Datenstrukturen
Tensor = [ /* Slice 1: */ [ [111, 112]
                          , [121, 122] ]
         , /* Slice 2: */ [ [211, 212]
                          , [221, 222] ]
         , /* Slice 3: */ [ [311, 312]
                          , [321, 322] ] ];

/* Dieser Abschnitt ist nur für die Inbetriebnahme
T1 = 12.34 * Tensor;
 */
La sequenza di caratteri // non viene considerata se si trova in una stringa contrassegnata con "..." o '...' o all'interno di un commento /* ... */. Nell'esempio, quindi, le assegnazioni a a ed e non vengono interpretate, mentre l'assegnazione a z sì.
/* Im Block-Kommentar wird // ignoriert */
s1 = "Dies ist ein //-Text und weder ein Kommentar noch eine Formel: 1+1";
/*
a = b + c;
e = f * g;
// */  z = b / g;
I marcatori di inizio e fine commento /*...*/ non vengono considerati se sono scritti dopo un // "visibile". Nell'esempio il blocco di commento è ora esso stesso commentato, le assegnazioni a a ed e vengono eseguite, mentre non viene più eseguita l'assegnazione a z.
// Im Zeilen-Kommentar werden /* und */ ignoriert
// /*
a = b + c;
e = f * g;
// */ z = b / g;
Se un commento di blocco /*...*/ iniziato non viene chiuso, viene segnalato un errore.
Costrutti di controllo
I costrutti di controllo iniziano all'inizio della riga con un carattere # e proseguono fino alla successiva fine riga non nascosta all'interno di un livello di parentesi. La struttura di un costrutto di controllo segue, a seconda della funzione, una sintassi definita di conseguenza. È possibile inserire commenti.
#controlA <parameter>
#controlB <name>[<parameter>](<parameter>){<code>}
#controlC <key>, <key>=<value>, …
Tramite i costrutti di controllo è possibile influenzare le funzioni del compilatore del modulo Math, l'elaborazione delle variabili e l'esecuzione del codice.
Un costrutto di controllo può quindi avere effetti sui termini scritti successivamente.
I costrutti di controllo sono raccolti in questo documento.
Realizzazione della funzionalità desiderata
Cassetta degli attrezzi
Per realizzare la funzionalità desiderata sono disponibili funzioni e operatori nelle seguenti categorie:
- operatori aritmetico-logici
- funzioni matematico-trigonometriche
- funzioni di filtro temporali (come ad es. derivazione e integrazione di funzioni)
- algoritmi numerici (ad es. FFT, decomposizione di matrici, interpolazione, predizione)
- campionamento (sampling) dei dati di misura
- funzioni di conteggio e timer
- funzioni di selezione, funzioni orientate ai bit e funzioni per la conversione dei tipi di dati (cast)
- il supporto di sequenze di espressioni e assegnazioni
- funzioni di testo (stringa)
Con il progredire dello sviluppo del modulo Math vengono aggiunte di continuo nuove funzioni e naturalmente vengono corretti anche errori nelle funzioni esistenti. A seconda della versione smartCORE distribuita è disponibile una determinata versione. Questa viene indicata, sotto forma di numero di catalogo progressivo, anche nel file di log, nell'esempio V11:
...|...|...|INFO   |module.math:  (II)  "Welcome to mathExpression library, git '0ed7f17-dirty', build 'Feb  2 2026 15:30:55'"
...|...|...|INFO   |module.math:  (II)  "Package 'mathExpCore', V11 (using V11)"
Esecuzione condizionale, cicli
A causa dell'elaborazione continua di dati in flusso con timestamp, ogni termine va inteso come un componente elettrico o un filtro in un circuito elettrico. L'implementazione di classici costrutti di controllo che influenzano l'esecuzione del testo delle formule risulta quindi priva di senso. Pertanto nel modulo di calcolo non si trovano i seguenti elementi del linguaggio o le loro varianti:
- IF-THEN-ELSE
- WHILE-DO
- REPEAT-UNTIL
- FOR-TO-DO, FOR-EACH
- SWITCH-CASE
Esistono tuttavia diverse funzioni con cui è possibile, ad es., scegliere tra diverse sorgenti di segnale. Ciò corrisponderebbe a un relè o a un multiplexer nella tecnica dei circuiti.
Altre funzioni consentono di memorizzare valori a un determinato istante o di rilevare variazioni di valore o fronti.
Per motivi analoghi al momento non esiste ancora alcuna implementazione per procedure o funzioni definite dall'utente.
Calcolo corretto nel tempo
Tutti i termini, gli operatori e le funzioni elaborano e producono sempre dati con timestamp, tipici dello smartCORE. Questi dati vengono combinati tra loro in modo corretto nel tempo, dove di norma per ogni timestamp di ingresso dei flussi di dati coinvolti in un termine viene calcolato un valore di uscita. In questo caso l'andamento del segnale tra due timestamp viene assunto come costante (elemento di mantenimento di ordine 0) con riferimento al valore più vecchio nell'intervallo di tempo, cioè il valore più vecchio vale fino all'istante immediatamente precedente il timestamp del valore più recente. Un'ulteriore elaborazione dei dati può quindi avvenire solo se a un determinato istante tutti i valori di ingresso coinvolti del termine hanno a loro volta valori validi. L'intervallo di tempo valido per il calcolo termina, per un flusso di dati, con il suo timestamp più recente. La tabella seguente mostra un esempio per due sorgenti di dati con timestamp A e B e un calcolo:
| Istante | A | B | A + B |
|---|---|---|---|
| 1 | (non definito) | 10 | (non definito) |
| 2 | 5 | 15 | |
| 3 | 20 | 25 | |
| 5 | 30 | 35 | |
| 8 | 8 | 38 | |
| 13 | 9 | 40 | 49 |
| 26 | 5 | 45 | |
| 27 | 2 | 42 | |
| 30 | (in sospeso) | 50 | (in sospeso) |
Ciò significa direttamente che per i dati forniti solo raramente o che, ad es. a causa dello spegnimento di un componente del sistema, non vengono più forniti affatto, tutti i calcoli che ne dipendono vengono dapprima elaborati solo fino a questo timestamp più recente e poi bloccati lì. Il modulo Math offre diverse possibilità per attenuare queste situazioni di blocco.
Con il parametro evaluationTimeMs viene definito solo l'intervallo di tempo in ms in cui l'interpreter elabora, su tutti i termini, tutti i punti dati disponibili a quell'istante (batch processing). Ciò comporta una certa "potenza reattiva". Per questo l'intervallo dovrebbe essere scelto almeno così lungo che in ogni ciclo possano essere elaborati anche dati, ma preferibilmente anche così breve che il numero dei singoli punti dati rimanga entro limiti contenuti (ca. < 100). Se ad es. si hanno esclusivamente sorgenti di dati che forniscono nuovi valori con cadenza di 2 secondi, si potrebbe impostare evaluationTimeMs a 5000 ms. Per sorgenti di dati che forniscono i loro punti dati a 1 kHz è più sensato un evaluationTimeMs di 100 ms. Un tempo di ciclo più breve è sensato anche quando con i risultati del set di formule devono essere realizzati compiti di controllo nel processo.
Grazie all'elaborazione dei dati corretta nel tempo, l'ordine delle espressioni nel set di formule non ha, in definitiva, alcun ruolo. Per motivi di leggibilità si raccomanda tuttavia di utilizzare solo variabili assegnate in precedenza.
Calcolo a tempo discreto
Il calcolo corretto nel tempo non può essere realizzato se le variabili vengono riportate su se stesse con un riferimento circolare. Un esempio di tale costrutto è l'implementazione di un semplice algoritmo di filtro ponderato:
y_out = weight * y_out + (1 - weight) * x_in;
Secondo la regola introdotta in precedenza, y_out viene ricalcolato per tutti gli istanti definiti dai dati di ingresso weight, y_out e x_in. Mentre weight e x_in sono impostati in modo indipendente come costanti (quindi sempre validi) oppure proseguono da un segnale di misura, y_out inizialmente non viene riempito affatto. Che cosa definisce il primo valore di y_out? E se questo è impostato con un timestamp, y_out può essere calcolato al massimo fino a esattamente questo timestamp - quindi per nulla, poiché questo istante è già assegnato.
Nella tecnica di regolazione e controllo, così come nei linguaggi di programmazione, l'espressione sopra riportata viene tuttavia interpretata nel senso che il "nuovo" valore y_out risulta, secondo la regola, dal "vecchio" y_out. Il "nuovo" y_out si trova quindi un passo di campionamento nel futuro, così che il calcolo successivo possa essere eseguito di conseguenza.
Il modulo Math riconosce i riferimenti circolari (anche indiretti) e commuta le variabili interessate a una regola di calcolo discreta. Le variabili avanzano ora con un intervallo di tempo fisso e una griglia, determinati dal parametro discreteSampleTimeMs. Tutti i calcoli discreti sono sincronizzati su questa griglia.
Per risolvere la questione del valore iniziale viene definita una sintassi speciale, che viene eseguita una sola volta: all'assegnazione del valore iniziale si aggiunge alla variabile il suffisso @0:
y_out@0 = x_in;
y_out   = weight * y_out + (1 - weight) * x_in;
Il primo valore disponibile sulla variabile di ingresso x_in viene utilizzato in questo esempio come valore iniziale nel punto della griglia immediatamente successivo per y_out. Da questo momento il calcolo e l'assegnazione di y_out procedono nell'intervallo di tempo fisso allineato.
A causa del campionamento, variazioni rapide del segnale comprese tra due istanti di campionamento possono andare perse. catch(x, {...}) può essere utilizzata per tenere conto di componenti critiche e più rapide del segnale all'interno dell'intervallo.
Identificatori e variabili
Per i nomi delle variabili (segnali, canali) valgono le seguenti convenzioni
- il primo carattere deve appartenere al gruppo a-z, A-Z o _
- tutti i caratteri successivi devono appartenere al gruppo a-z, A-Z, 0-9 o _
- viene distinta la scrittura maiuscola/minuscola
- tutti i caratteri non citati, come ad es. dieresi, caratteri speciali, parentesi, simboli matematici, spazi, non sono ammessi!
Tutti gli identificatori distinguono tra maiuscole e minuscole (case-sensitive), cioè "varIABLE", "Variable" e "VARiable" sono tre identificatori diversi.
È possibile includere nel calcolo i dati di canali smartCORE esistenti indicando il nome del canale. Se per questo è necessario accedere a canali smartCORE il cui nome viola la regola precedente, esiste una possibilità tramite le seguenti notazioni
$'Some + strange.å =channel ů /name!'
$"Some + strange.å =channel ů /name!"
Lo stesso vale per i canali che devono essere restituiti allo smartCORE e che richiedono una denominazione particolare.
A una variabile può essere assegnato un valore in un solo punto. Le variabili senza un'assegnazione locale vengono cercate come sorgente di dati nel contesto dello smartCORE. Ciò vale anche per le variabili che rappresentano uscite secondarie di un blocco funzionale e che vengono definite con le proprietà.
Costanti
I seguenti identificatori sono disponibili come costanti nel contesto del testo delle formule:
| Identificatore | Valore | Tipo |
|---|---|---|
| true | true | <bool> |
| on | true | <bool> |
| yes | true | <bool> |
| high | true | <bool> |
| false | false | <bool> |
| off | false | <bool> |
| no | false | <bool> |
| low | false | <bool> |
| pi | <dbl> | |
| magic | <uint> | |
| j | <cxFlt> |
Se nello smartCORE esistono variabili con uno di questi nomi, la notazione speciale per le variabili $'…' (vedere Identificatori) può garantire la distinzione. Per il resto ha priorità l'uso dell'identificatore come costante.
Tipi di dati e conversione dei tipi
Tipi di dati
Il modulo Math sceglie per il calcolo di volta in volta un tipo di dati adatto, per poter eseguire le operazioni desiderate con la migliore rappresentazione possibile. I tipi sono i seguenti
| Tipo di dati | Designazione | Descrizione | Lunghezza in bit | Minimo | Massimo |
|---|---|---|---|---|---|
| boolean | <bool> | Valore di verità | 1 | false, no, off, low | true, on, yes, high |
| unsigned integer | <uint> | Numero intero senza segno | 64 | 0 | 18446744073709551615 |
| integer | <int> | Numero intero con segno | 64 | -9223372036854775808 | +9223372036854775807 |
| Risoluzione minima | Intervallo di valori | ||||
| double | <dbl> | Numero in virgola mobile a precisione doppia | 64 | ±5.0E-324 | ±1.7976931348623157E+308 |
| complex float | <cxFlt> | numero complesso in virgola mobile a precisione singola (*) | 2x 32 | ±1.175494E-38 per componente Re/Im | ±3.402823E+38 per componente Re/Im |
| string | <str> | Testo, UTF-8 | N/A | N/A | N/A |
Di norma non occorre preoccuparsi del tipo; al passaggio allo smartCORE viene eseguita la conversione adeguata nel tipo di dati indicato a tale scopo.
In questa descrizione delle funzioni il tipo di dati viene solitamente racchiuso tra parentesi angolari, quindi ad es. <bool> o <str>.
Conversione automatica dei tipi
Nell'elaborazione di dati numerici tramite operatori binari avviene la seguente conversione automatica dei tipi in relazione ai tipi degli operandi
| bool | uint | int | dbl | cxFlt | str | |
|---|---|---|---|---|---|---|
| bool | bool | uint | int | dbl | cxFlt | str |
| uint | uint | uint | int | dbl | cxFlt | str |
| int | int | int | int | dbl | cxFlt | str |
| dbl | dbl | dbl | dbl | dbl | cxFlt | str |
| cxFlt | cxFlt | cxFlt | cxFlt | cxFlt | cxFlt | str |
| str | str | str | str | str | str | str |
In questo modo, il più a lungo possibile rimangono
- i valori booleani solo true/false
- le proprietà dei valori uint per le operazioni sui bit
- il segno nell'uso di valori int
- la precisione dei numeri in virgola mobile
- disponibile lo spazio dei numeri complessi
Particolarità per bool
-
Nella conversione in
<bool>vale implicitamente il confronto diverso da 0 per ottenere il valore di verità. -
Nella conversione da
<bool>a un tipo numerico, false diventa 0 e true diventa 1. -
Nell'addizione di due valori booleani la conversione avviene in
<uint>. -
Nella sottrazione di due valori booleani la conversione avviene in
<int>. -
Nel calcolo di campi di dati di tipo
<bool>il risultato è sempre<int>.
Particolarità per uint
-
Nella sottrazione di due
<uint>-<uint>senza segno il risultato è<int>, se il secondo operando è maggiore del primo. In questo modo si evita l'overflow, per lo più del tutto privo di senso e non voluto, nell'ordine di grandezza di 2^64. -
Nel calcolo di campi di dati di tipo
<uint>il risultato è sempre<int>.
Conversione manuale dei tipi
È ugualmente possibile eseguire una conversione manuale dei tipi utilizzando le seguenti funzioni
| Funzione | Descrizione |
|---|---|
bool(x) | Conversione dell'argomento x in bool |
uint(x) | Conversione dell'argomento x in uint |
int(x) | Conversione dell'argomento x in int |
dbl(x) | Conversione dell'argomento x in double |
str(x) | Conversione dell'argomento x in string |
Tipi numerici
Direttamente nel testo delle formule e negli oggetti di configurazione per le proprietà delle funzioni, i valori numerici possono essere indicati anche in sistemi numerici diversi. Esempi di notazione sono:
  aBool         = true;         // alt.: false, on, off, yes, no, high, low
  anUnsignedInt = 42;           // alt.: 42u
  aHexUInt      = 0x2A;         // alt.: 2Ah
  anOctUInt     = 052;          // alt.: 52o
  aBinUInt      = 0b10'1010;    // alt.: 101010b
  aSignedInt    = -42;
  aDouble       = 3.14159;      // alt.: 1.6022e–19, pi, !! decimal-point
  aComplex      = 2.7+1.0*j;    // alt.: cx(2.7, 1.0)
Separatore di gruppo
Per i numeri interi senza segno (<uint>) o con segno (<int>) le singole cifre possono essere suddivise in gruppi inserendo un apice semplice '. Questo carattere non ha alcun ruolo nell'interpretazione del valore numerico, ma semplifica la lettura. Non deve trovarsi all'inizio o alla fine di un numero.
aHexUInt      = FFe7'0815'337Eh;    // 0815 ist hier kein String!
aBinUInt      = 0b1011'0110'1010;
aLargeInt     = 1'000'000'000;
Segno e negazione
Anteponendo un operatore - si ottiene il valore negativo per ogni formato numerico (complemento a 2).
Anteporre l'operatore + è consentito, ma privo di funzione.
L'operatore ~ inverte a livello di bit un numero intero <uint> (esempio: ~0b1010'0011'1100 -> 0b1111...1111'0101'1100'0011).
Formato numerico esadecimale
La rappresentazione di un numero nel sistema esadecimale (base 16) avviene anteponendo 0x o 0X oppure aggiungendo la lettera h. Le cifre possibili sono 0 .. 9, a .. f o A .. F e il separatore di gruppo.
L'indicazione di un numero nel sistema esadecimale viene sempre interpretata come senza segno, ma può essere negata con l'operatore - o invertita con ~.
Formato numerico ottale
La rappresentazione di un numero nel sistema ottale (base 8) avviene anteponendo uno 0 (zero) oppure aggiungendo la lettera o. Le cifre possibili sono 0 .. 7 e il separatore di gruppo.
L'indicazione di un numero nel sistema ottale viene sempre interpretata come senza segno, ma può essere negata con l'operatore - o invertita con ~.
Formato numerico binario
La rappresentazione di un numero nel sistema binario (base 2) avviene anteponendo 0b o 0B oppure aggiungendo la lettera b. Le cifre possibili sono 0 .. 1 e il separatore di gruppo.
L'indicazione di un numero nel sistema binario viene sempre interpretata come senza segno, ma può essere negata con l'operatore - o invertita con ~..
Stringhe (letterali stringa)
Le stringhe costanti vengono racchiuse tra apici semplici ' o doppi ". Se una stringa contiene a sua volta un ' o un ", questo deve essere contrassegnato anteponendo un carattere di escape \. Esempi:
s1a = '17" (inch)';
s1b = "17\" (inch)";
s2a = "Hat's funktioniert?";
s2b = 'Hat\'s funktioniert?';
In generale i caratteri speciali nelle stringhe, utilizzati ad es. per espressioni regolari nella ricerca di testo o nell'interpretazione o generazione di protocolli seriali di dispositivi, possono essere rappresentati tramite le seguenti sequenze di escape:
| Carattere | Nome ASCII | Valore ASCII | Sequenza di escape |
|---|---|---|---|
| Newline (Linefeed) | NL (LF) | 10 | \n |
| Horizontal tab | HT | 9 | \t |
| Vertical tab | VT | 11 | \v |
| Backspace | BS | 8 | \b |
| Carriage return | CR | 13 | \r |
| Formfeed | FF | 12 | \f |
| Alert | BEL | 7 | \a |
| Escape | ESC | 27 | \e |
| Backslash | \ | 92 | \\ |
| Question mark | ? | 63 | \? |
| Single quotation mark | ' | 39 | \' |
| Double quotation mark | " | 34 | \" |
| Character from octal code | NNN = 000 .. 377 (octal digits) | \oNNN\o{N...} | |
| Character from decimal code | NNN = 000 .. 255 (decimal digits) | \dNNN\d{N...} | |
| Character from hex code | NN = 00 .. FF (hex digits) | \xNN\x{N...} | |
| UTF characer(s) from decimal code | UTF8-Multibyte | NNNN = x0000 .. xFFFF x00000000 .. x0010FFFF | \uNNNN\UNNNNNNNN\u{N...} |
La codifica dei caratteri avviene internamente sempre in UTF-8 (UTF-8 – Wikipedia).
Operatori aritmetico-logici
In questa sezione vengono illustrati gli operatori aritmetico-logici, inclusi la loro precedenza e associatività.
Associatività
Un operatore ° viene definito associativo a sinistra se vale quanto segue
a ° b ° c = (a ° b) ° c
e di conseguenza associativo a destra se vale
a ° b ° c = a ° (b ° c)
Un operatore * ha una precedenza (priorità, forza di legame) maggiore dell'operatore + se, indipendentemente dalle associatività di entrambi gli operatori, vale
a + b * c = a + (b * c)
Quando il legame tra i termini non è immediatamente evidente, si raccomanda di imporre l'ordine di valutazione voluto con un uso abbondante di (...). Soprattutto per gli operatori logici o di confronto la precedenza non è sempre familiare. Per espressioni complesse si raccomanda inoltre l'uso di più righe consecutive e un opportuno allineamento dei termini per strutturare il testo.
res = A && (B || (C && D) || (E && (F || G)));    // Variante 1
opt = A && (    B                  // optionaler Kommentar
            || (C && D)            // optionaler Kommentar
            || (E && (   F         // optionaler Kommentar
                      || G)        // optionaler Kommentar
               )
           );                                    // Variante 2
Operatori
La tabella seguente contiene gli operatori disponibili, ordinati per precedenza crescente. Tutti gli operatori qui elencati operano sui tipi di dati introdotti in precedenza. Per le combinazioni e operazioni logiche orientate ai bit sono disponibili funzioni apposite.
| Operatore | Assegnazione | Associatività | Descrizione | Esempio | Tipo del risultato |
|---|---|---|---|---|---|
| ; | sinistra | sequenza di istruzioni eseguita indipendentemente dal tempo | y = 7; x = 4 | void | |
| , | sinistra | concatenazione di singole espressioni | a = 4, b = 6, a + b | come l'ultima espressione | |
| += | SÌ | destra | assegnazione composta rispetto all'addizione | a += 17 | automatico |
| -= | SÌ | destra | assegnazione composta rispetto alla sottrazione | a -= b | automatico |
| *= | SÌ | destra | assegnazione composta rispetto alla moltiplicazione | a *= b | automatico |
| /= | SÌ | destra | assegnazione composta rispetto alla divisione | a *= b | automatico |
| %= | SÌ | destra | assegnazione composta rispetto al modulo | b %= 4 | automatico |
| = | SÌ | destra | assegnazione | a = 23 * b | come l'espressione assegnata |
| ? : | destra | operatore ternario if-else | (a > 23) ? 12 : -50 | come il corpo risultante | |
| || | sinistra | disgiunzione logica (OR) | a || b | <bool> | |
| && | sinistra | congiunzione logica (AND) | a && b | <bool> | |
| ^^ | sinistra | antivalenza logica (XOR) | a ^^ b | <bool> | |
| == | sinistra | uguaglianza | a == b | <bool> | |
| != | sinistra | disuguaglianza | a != b | <bool> | |
< | sinistra | minore di | a < b | <bool> | |
<= | sinistra | minore o uguale | a <= b | <bool> | |
> | sinistra | maggiore di | a > b | <bool> | |
>= | sinistra | maggiore o uguale | a >= b | <bool> | |
| + | sinistra | addizione | a + b | automatico | |
| - | sinistra | sottrazione | a - b | automatico | |
| * | sinistra | moltiplicazione | a * b | automatico | |
| / | sinistra | divisione | a / b | automatico | |
| % | sinistra | modulo | a % b | automatico | |
| ^ | destra | elevamento a potenza | a ^ 0.333 | <dbl> | |
| ! | destra | inversione logica (NOT) | !(a && b) | <bool> | |
| ~ | destra | inversione orientata ai bit | ~a | <uint> | |
| + | destra | segno positivo | 6 / +a | automatico | |
| - | destra | segno negativo | 9 * -a | automatico |
Operatori di assegnazione
A una variabile può essere assegnato un valore in un solo e unico punto del testo delle formule. Le variabili senza un'assegnazione locale vengono cercate come sorgente di dati nel contesto dello smartCORE.
Con gli operatori di assegnazione sul lato sinistro deve trovarsi obbligatoriamente una variabile (x, y, …), un elemento di una matrice già assegnata in precedenza (V[2], M[0,2], …) oppure l'inizializzatore di una variabile campionata in modo discreto (k@0, …), in cui viene memorizzato il risultato. Il risultato dell'espressione rimane il valore assegnato. In questo modo diventa possibile anche concatenare assegnazioni o utilizzare un'assegnazione all'interno di un'espressione.
Operatori per campi di dati
Se gli operatori +, -, * e / vengono applicati a campi di dati (vettori, matrici, tensori), valgono le regole usuali della matematica riguardo alla dimensione degli operandi e alla conseguente dimensione del risultato. Valgono le seguenti regole:
-
Per l'addizione e la sottrazione i campi di dati coinvolti devono avere la stessa dimensione. L'operazione avviene sugli elementi con gli stessi indici.
-
Un campo di dati può essere moltiplicato a piacere per uno scalare:
DF * soppures * DF. L'operazione viene eseguita per ogni elemento. -
Un campo di dati può essere diviso solo per uno scalare:
DF / sL'operazione viene eseguita per ogni elemento. -
Per la moltiplicazione il primo campo di dati deve avere tante colonne quante righe ha il secondo campo di dati. Il risultato contiene tante righe quante il primo campo di dati e tante colonne quante il secondo campo di dati.
Poiché per i vettori non si distingue esplicitamente tra vettore riga e vettore colonna, valgono le seguenti regole:-
Il prodotto di due vettori della stessa lunghezza è sempre il prodotto scalare.
-
Per il prodotto vettoriale di vettori a 2 e 3 componenti deve essere utilizzata la funzione
Cross(v1, v2). -
Il prodotto tra vettore e matrice legge il vettore come vettore riga.
-
Il prodotto tra matrice e vettore legge il vettore come vettore colonna.
-
Uguaglianza di campi di dati
Due campi di dati sono uguali se e solo se coincidono esattamente per tipo di dati, dimensione e tutti gli elementi. Prima del confronto non avviene alcuna conversione automatica dei tipi. Due campi di dati sono diversi se non sono uguali rispetto alla definizione precedente.
Altri confronti non sono disponibili.
Parentesi
Le seguenti coppie di parentesi vengono riconosciute anche in espressioni annidate. Ogni parentesi aperta deve essere chiusa correttamente nell'ordine giusto.
| Parentesi | Significato | Esempio |
|---|---|---|
( ... ) | Raggruppamento nell'ordine di valutazione, raggruppamento dei parametri di funzione | (a+b)/2, max(a, b, 50) |
[ ... ] | Riservate alla rappresentazione di vettori, matrici e tensori e all'indicizzazione delle variabili, l'indicizzazione conta sempre da 0…(N-1), per i vettori : V[<idx>], non si distingue tra vettore riga e colonnaper le matrici: M[<row>, <col>] per i tensori: T[<slice>,<row>, <col>] | a = [1, 2, 3], b = [[1.1, 1.2], [2.1, 2.2]], a[1] + b[0,1] |
{ ... } | - Parentesi per oggetti JSON utilizzabili per la parametrizzazione di blocchi funzionali. Poiché questi possono diventare molto estesi, si raccomanda di rimandare tramite un link $ref: '<path>' a una risorsa JSON esterna, raccolta in un contenitore separato del modulo di calcolo. | timer({ interval: 60 }) |
? ... : | L'espressione tra ? e : è implicitamente racchiusa tra (…). |
Funzioni
Le funzioni per il modulo Math sono messe a disposizione dal plug-in stesso, in futuro anche tramite ulteriori plug-in tematici per il modulo Math, e sono implementate in linea di principio in C++.
Chiamata di funzione
Ogni funzione è costituita da un nome di funzione che segue la consueta sintassi degli identificatori
- il primo carattere è del gruppo a-z, A-Z o _
- tutti i caratteri successivi sono del gruppo a-z, A-Z, 0-9 o _
- viene distinta la scrittura maiuscola/minuscola
seguito da un elenco di parametri che contiene in ( ... ) un elenco di singoli termini separati da virgola.
Nella descrizione di blocchi funzionali complessi i parametri della funzione vengono denominati anche ingressi e il valore di ritorno della funzione uscita.
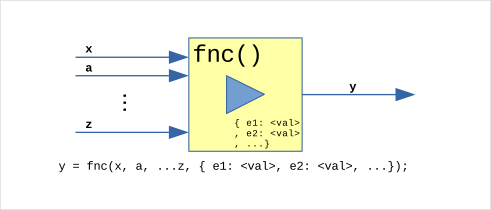
Gli identificatori per i namespace possono essere anteposti al nome della funzione tramite un '.'. Per il resto gli identificatori per i namespace seguono le stesse regole.
Esempi di chiamate di funzione
   f1  = functionNoParam();
   f2  = functionOneParam(x);
   f3a = functionOptionalParam(x,a);
   f3b = functionOptionalParam(x,a,b);
   f3c = functionOptionalParam(x,a,b,c);
   f4  = functionWithConfig(x,y,z, {...});
Per i parametri si distingue tra parametri obbligatori e opzionali (ingressi), nonché un oggetto di configurazione per le proprietà della funzione come ultimo elemento. Il significato dei parametri può variare con il numero di parametri utilizzati; ciò è da desumere dalla descrizione della funzione.
Per evitare ridondanze e i relativi errori, nella descrizione della funzione si lavora con segnaposto .... Di norma vengono elencate tutte le varianti con parametri opzionali, nonché una voce aggiuntiva in cui è descritto solo l'oggetto di configurazione:
f1 = aFunction(x);
f2 = aFunction(x, y);
// Optionale Konfiguration für alle Varianten
fx = aFunction(..., { eigenschaft1: <typ>
                    , eigenschaft2: <typ>
                    });
Se l'oggetto di configurazione è obbligatorio in una variante, è elencato direttamente in quella variante anche come segnaposto.
f1 = bFunction(x, {...});    // Konfiguration verpflichtend
f2 = bFunction(x, y, z);     // Konfiguration optional
// Konfiguration für alle Varianten
fx = bFunction(..., { eigenschaft1: <typ>
                    , eigenschaft2: <typ>
                    });
Ogni utilizzo di una funzione nel testo delle formule è rappresentato da un'istanza propria, in cui ad es. stati o aggregazioni possono essere memorizzati da un ciclo di calcolo al successivo. Ne sono esempi
- contatori
- sommatori, integratori
- filtri
- isteresi
- elementi logici con funzione di memoria
- funzioni con riferimento temporale
Le funzioni vengono di norma eseguite e producono un valore di uscita quando per tutti i parametri sono presenti valori validi e almeno un parametro porta un nuovo timestamp. Inoltre alcune funzioni vengono eseguite anche quando è soddisfatta una condizione temporale (interna).
Determinate funzioni, come ad es. integrate() o stopwatch(), contrassegnano i propri dati di uscita in modo tale che tra due punti dati concreti i calcoli successivi possano anche interpolare linearmente. Ciò migliora la qualità del calcolo, poiché qui è noto che un segnale di ingresso costante porterà a un segnale di uscita lineare.
Le funzioni possono inoltre collocare nel flusso di dati valori di uscita aggiuntivi indipendentemente dai timestamp dei valori dei parametri o dal ciclo di elaborazione, ad es. quando allo scadere di un temporizzatore un segnale deve essere resettato o quando la forma del segnale di uscita è definita dalla funzione stessa. Ne sono esempi le funzioni posedge() e negedge(), che al rilevamento di un fronte scrivono nel flusso di dati di uscita un impulso della durata di 1 nanosecondo.
Configurazione delle proprietà delle funzioni
Il comportamento di determinate funzioni può essere impostato, ottimizzato o modificato tramite proprietà. Queste proprietà vengono passate alla funzione in un oggetto di configurazione {...} all'ultima posizione dell'elenco dei parametri.
La sintassi implementata consente, rispetto allo standard JSON, alcune semplificazioni ma anche estensioni sensate, ad es. per liberare la rappresentazione JSON nella proprietà "math" da troppe sequenze di escape \:
- I nomi delle proprietà o i tag ENUM non devono essere racchiusi tra apici
- L'uso di virgolette
"..."e'...'per l'assegnazione di stringhe è equivalente. - Per i valori numerici interi possono essere utilizzate per l'input tutte le notazioni, come ad es.
0x...o0.... - Alcune proprietà consentono, in alternativa all'indicazione di un valore numerico, anche determinati tag ENUM, ad es. per disattivare la funzione corrispondente (
'off') o per impostare valori standard ('def','auto', ...) - Sono ammessi commenti in entrambe le notazioni
// ...e/* ... */
Per le proprietà sono previsti i seguenti tipi:
| Tipo | Valori | Esempio |
|---|---|---|
<bool> | true, on, yes, 1 false, off, no, 0 | edge: yes |
<uint> | valori interi positivi anche in notazione 0x- (hex) o 0- (octal) | range: 0x7F |
<int> | valori interi con segno | min: -10 |
<dbl> | numeri in virgola mobile (punto decimale!) anche in notazione esponenziale 1.35e-22 | delay: 13.45 |
<time>1 | numeri in virgola mobile come intervallo di tempo in secondi, con un'estensione per poter inserire opzionalmente anche minuti, ore o giorni interi. | longPeriod: 9025.3longPeriod: 2:30:25.3 |
<date>1 | numeri in virgola mobile come timestamp assoluto (secondi UTC dal 01.01.1970), con un'estensione per poter indicare opzionalmente anche data+timestamp UTC in formato ISO. | tBegin: 1770204975.256 tBegin: 2026-02-04T11:36:15.256 |
<cxFlt> | numero complesso in virgola mobile | pole: (-5, 0.8) |
<str> | Stringa / testo, apici obbligatori solo se contiene spazi, virgole o caratteri speciali. | storage: 'total_km' |
<var> | Variant, può assumere tutti i tipi sopra citati | preset: 0x2F |
<enum> | Determinati tag enumerativi, vedere la descrizione della funzione | mode: peak2 |
off/<typ> | Alternativa tra tag enum o un tipo regolare <typ> | lower: off,upper: 12.6 |
[<typ>] | Vettore separato da virgole con dati di tipo <typ> | map: [1,2,4,8] |
Con l'aiuto della parola chiave riservata $ref il contenuto della configurazione può essere ricavato interamente da una risorsa. Può trattarsi di una configurazione nel formato JSON semplificato descritto in precedenza oppure anche di un testo arbitrario o addirittura di contenuto binario, se la funzione lo richiede e lo supporta.
f = someConfigExpectingFunction({$ref:'someNamedResource'});
La configurazione è in linea di principio costante durante l'esecuzione. Un calcolo dei valori delle proprietà non è ammesso. Un collegamento a variabili nel set di formule non è possibile. Alcune funzioni dispongono a tale scopo di parametri opzionali che consentono di modificare dinamicamente impostazioni come ad es. valori limite.
Le proprietà elencate nella documentazione sono opzionali, a meno che non siano contrassegnate come obbligatorie (mandatory).
Informazioni di stato persistenti
Determinate funzioni, utilizzate preferibilmente per l'aggregazione di segnali o eventi, possono memorizzare il loro stato interno tramite i canali persistenti dello smartCORE e, dopo un riavvio del software, proseguire dallo stato memorizzato in precedenza e continuare il calcolo. Ne sono esempi
- contatori
- integratori
- classificazioni
A tale scopo, nell'area della configurazione JSON della funzione corrispondente viene indicato il nome di una posizione di memorizzazione tramite la proprietà storage. Il contenuto di questa variabile, creata e gestita automaticamente, di norma non è interpretabile dall'utente né da altre unità funzionali dello smartCORE. L'uso della stessa memoria in punti diversi del testo delle formule non è ammesso.
Se nella memoria viene reso persistente uno stato riferito a una grandezza fisica, si raccomanda di aggiungere al nome un identificativo della relativa unità (ad es. 'totalDistance_km'), per semplificare la leggibilità e la successiva manutenzione del testo delle formule.
Al contenuto della memoria persistente si può accedere nuovamente esclusivamente tramite la stessa funzione.
Nell'esempio seguente viene reso persistente il valore di un contatore:
f = someCounterFunction(someCondition, {storage:'some.counter.variable'});
Tutti i dati persistenti vengono salvati periodicamente come BLOB in un database SQLite. Le voci in questo database non vengono rimosse automaticamente.