Modulo di monitoraggio "diagnostics"
Descrizione
Compito del modulo di monitoraggio "diagnostics" è monitorare diversi tipi di dati di ingresso rispetto a criteri definiti e scrivere successivamente le informazioni di allarme che ne risultano nel database degli allarmi smartCORE dell'Alarm Manager.
Per l'ulteriore elaborazione dei messaggi di allarme, questo database può essere collegato a optiCloud, ad es. con il plug-in opticloud.
Tra i tipi di dati di ingresso monitorati rientrano, tra l'altro,
- Valori booleani, ad es. flag di stato o risultati di logiche calcolate
- Valori Double (virgola mobile), ad es. valori di misura o grandezze calcolate, che vengono confrontati con un valore limite fisso. È prevista un'isteresi impostabile per la soppressione del rumore. Per tracciare i valori estremi, è possibile attivare gli aggiornamenti del messaggio.
- Codici Integer, ad es. codici di stato o ENUM oppure determinati bit o sezioni di bit; i singoli codici o intervalli di codici possono essere filtrati mediante una white/black list e assegnati rispettivamente allo stato HIGH o LOW. I codici non corrispondenti vengono segnalati tramite un allarme di stato di errore dedicato fino all'arrivo di un codice valido. Per tracciare i cambi di stato, è possibile attivare gli aggiornamenti del messaggio.
- Valori String (testo), ad es. messaggi del registro di bordo di un dispositivo; gli elementi di testo possono essere estratti tramite Regular Expressions (PCRE), filtrati come white/black list e assegnati allo stato HIGH o LOW. I testi non corrispondenti vengono segnalati tramite un allarme di stato di errore dedicato fino all'arrivo di un codice valido.
- ErrorCode: una sequenza di codici di errore (
<string>) in combinazione con un canale di livello oppure con un canale di trasferimento. Il modulo Diagnostics mantiene internamente una tabella con i codici di errore e la relativa istanza di messaggio. I messaggi possono essere assegnati a singoli codici oppure, come template, a un intervallo di codici (wildcard) o a tutti i codici in ingresso.
Inoltre, nell'ambito della composizione dei messaggi di allarme vengono acquisiti valori attuali dei canali smartCORE (i cosiddetti snapshot) e integrati metadati definiti dall'utente. Lo schema seguente offre una panoramica della funzionalità implementata della logica di allarme. Per ogni voce Message sono disponibili i blocchi evidenziati in giallo chiaro:
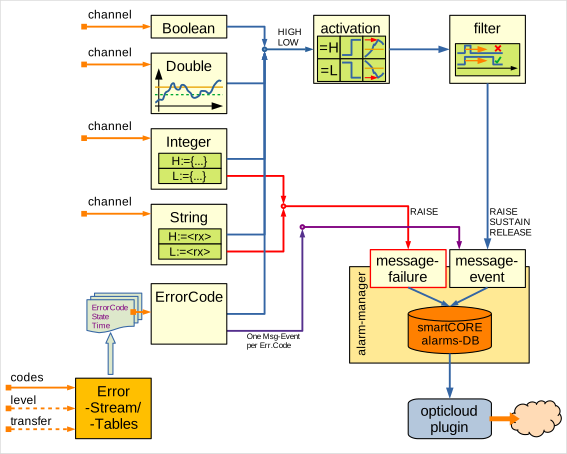
L'elaborazione dei dati di un canale monitorato avviene dal punto di vista del plug-in di diagnostica, cioè ha luogo una conversione implicita nel tipo di dati previsto. Il tipo di dati del canale è quindi irrilevante per la valutazione, purché sia convertibile in modo corrispondente.
Interfacce e protocolli utilizzati
- Database degli allarmi smartCORE
Configurazione JSON
Nelle sezioni seguenti vengono elencate configurazioni di esempio e discussi i parametri del modulo coinvolti.
Configurazione di esempio (monitoraggio di valori booleani)
In questo esempio un canale viene letto come Boolean e monitorato per il valore true.
Per la conversione del tipo di dati vale quanto segue:
<integer>,<unsigned integer>o<double>è true se il campione è ,<string>è true se la stringa non è vuota
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "messages": [
      {
        "messageLevel": "WARNING",
        "context": "Monitoring someBooleanChannel",
        "channel": "someBooleanChannel",
        "activation": "high"
      }
    ]
  }
}
Configurazione di esempio (monitoraggio del superamento di un valore numerico con ritardi di stabilizzazione e isteresi)
In questo esempio un canale viene letto come Double e monitorato per il superamento del valore di 42.0.
Per la conversione del tipo di dati vale quanto segue:
- i valori
<bool>vengono tradotti in 0 e 1, <string>fornisce come valore la lunghezza della stringa
Nell'esempio, per l'attivazione è necessario che il superamento duri almeno 5 secondi e, per la disattivazione, che questo non sia presente per almeno 10 secondi e che a tale scopo il valore del canale si trovi al di sotto della soglia meno la sua isteresi.
Viene inoltre generato un messaggio relativo all'evento, che contiene il valore attuale, l'estremo finora raggiunto, cioè in questo caso il massimo, nonché la soglia.
Questo messaggio viene aggiornato sia al superamento iniziale sia alla disattivazione. Inoltre questo messaggio viene aggiornato anche in caso di scostamenti del valore attuale dall'ultimo estremo segnalato che siano maggiori dell'isteresi.
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "messages": [
      {
        "messageLevel": "WARNING",
        "context": "Monitoring measured someValueChannel",
        "messageEvent": "Some WARNING occurred (current value ${value} > ${boundary}) (maximum value ${minmax} on ${minmaxDate} at ${minmaxTime})",
        "channel": "someValueChannel",
        "threshold": 42.0,
        "hysteresis": 7.0,
        "activation": "high",
        "stabilizationSecondsRaise": 5,
        "stabilizationSecondsRelease": 10
      }
    ]
  }
}
Configurazione di esempio (monitoraggio di valori enumerati)
In questo esempio un canale viene letto come valore Integer e monitorato.
Per la conversione del tipo di dati vale quanto segue:
- i valori
<bool>vengono tradotti in 0 e 1, - i valori
<float>o<double>vengono utilizzati senza cifre decimali, <string>fornisce come valore la lunghezza della stringa
In questo esempio gli intervalli di valori 17 e 77-99 vengono interpretati come condizione di attivazione (HIGH), gli intervalli di valori 31-39, 66 e 69-71 come condizione di disattivazione (LOW) e tutti gli altri intervalli come condizione di allarme non valida.
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "messages": [
      {
        "messageLevel": "WARNING",
        "context": "Monitoring someEnumeratedChannel",
        "messageEvent": "Some WARNING occurred",
        "messageFailure": "INVALID error occurred",
        "channel": "someEnumeratedChannel",
        "activation": "enum",
        "valuesHigh": "17,77-99",
        "valuesLow": "31-39,66,69-71"
      }
    ]
  }
}
Configurazione di esempio (monitoraggio di un Error Stream)
In questo esempio vengono monitorati codici di errore (ErrorCode) provenienti da un cosiddetto Error Stream.
Questo è costituito dai due canali sourceErrorCode e sourceErrorLevel, che devono essere sincroni nel tempo. Il canale del codice di errore viene letto come <string>, così che possano essere utilizzati come fonte canali pressoché qualsiasi. Il canale del livello di errore deve fornire valori interi <integer>. I codici estratti da questo Error Stream sono a disposizione di tutti i messaggi ErrorCode per l'elaborazione nell'ordine della loro definizione. Un determinato codice può essere considerato di volta in volta in un solo messaggio ErrorCode.
Nell'esempio vengono monitorati sia il codice di errore specifico dell'utente "47:11", sia i codici di errore che iniziano con "ERR:", sia tutti gli altri codici di errore sconosciuti. Se l'oggetto Message deve essere utilizzato per diversi codici, deve essere contrassegnato come template.
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "sourceErrorCode": "Some.Name.Space.ErrorCodeChannel",
    "sourceErrorLevel": "Some.Name.Space.ErrorLevelChannel",
    "messages": [
      {
        "errorCode": "47:11",
        "messageLevel": "ALARM",
        "context": "Monitoring Error-Stream for 47:11",
        "messageEvent": "ALARM ${errorCode} occurred"
      },
      {
        "isTemplate": true,
        "errorCode": "ERR:*",
        "messageLevel": "ERROR",
        "context": "Monitoring for ERR-codes",
        "messageEvent": "Error ${errorCode} occurred"
      },
      {
        "isTemplate": true,
        "messageLevel": "WARNING",
        "context": "Collection unknown codes",
        "messageEvent": "Unknown code ${errorCode} occurred"
      }
    ]
  }
}
Configurazione di esempio (utilizzo di metadati)
In questo esempio un canale viene monitorato per il valore true come nell'Esempio 1. Scopo di questo esempio è illustrare l'integrazione dei messaggi di allarme con metadati specifici dell'utente.
A tale scopo, nell'ambito della composizione del messaggio di allarme vengono aggiunti metadati sotto forma di oggetto JSON, dove i metadati globali vengono sempre integrati con i metadati specificati nell'ambito del Message oppure sostituiti al livello più alto dell'oggetto JSON.
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "globalMetadata": {
      "actionToBePerformed":"some generic action",
      "consequences":[
        "consequence1",
        "consequence2"
      ]
    },
    "messages": [
      {
        "messageLevel": "WARNING",
        "context": "Monitoring someBooleanChannel",
        "channel": "someBooleanChannel",
        "activation": "high",
        "metadata": {
          "actionToBePerformed":"some CRITICAL action",
          "consequences":[
            "some SEVERE consequence",
            "consequence1",
            "consequence2"
          ],
          "additionalRemarks":[
            "some REMARK"
          ]
        }
      }
    ]
  }
}
Configurazione di esempio (utilizzo di canali snapshot)
In questo esempio un canale viene monitorato per il valore true come nell'Esempio 1.
Scopo di questo esempio è illustrare l'integrazione dei messaggi di allarme con uno snapshot specifico dell'utente di valori dei canali.
A tale scopo, al momento della prima comparsa della condizione di allarme viene realizzata un'istantanea dei canali smartCORE elencati, costituita dall'unione di tutti i canali snapshot globali e relativi al messaggio.
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "globalSnapshot": [
      "someGps.Location",
      "someOutsideTemperature"
    ],
    "messages": [
      {
        "messageLevel": "WARNING",
        "context": "Monitoring someBooleanChannel",
        "channel": "someBooleanChannel",
        "activation": "high",
        "snapshot": [
          "somePressure",
          "someTemperature",
          "someQuantity",
        ]
      }
    ]
  }
}
Configurazione di esempio (utilizzo di gruppi snapshot)
In questo esempio un canale viene monitorato per il valore true come nell'Esempio 1.
Questo esempio illustra inoltre l'utilizzo dei cosiddetti gruppi snapshot.
{
  "module": "diagnostics",
  "factory": "diagnostics",
  "config": {
    "pollingIntervalMs": 1000,
    "snapshotGroups": [
      {
        "name": "gpsInfoChannels",
        "channels": [
          "GPS.Location",
          "GPS.Altitude",
          "GPS.SatCount"
        ]
      },
      {
        "name": "EngineOilPTQChannels",
        "channels": [
          "Engine.Oil.Pressure",
          "Engine.Oil.Temperature",
          "Engine.Oil.Quantity"
        ]
      }
    ],
    "globalSnapshot": [
      "gpsInfoChannels",
      "someOutsideTemperature"
    ],
    "messages": [
      {
        "messageLevel": "WARNING",
        "context": "Monitoring someBooleanChannel",
        "channel": "someBooleanChannel",
        "activation": "high",
        "snapshot": [
          "Engine.Revs",
          "EngineOilPTQChannels"
        ]
      }
    ]
  }
}
Parametri globali del modulo
Nella sezione seguente vengono discussi tutti i parametri del modulo.
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| pollingIntervalMs | No | INT | 1 - | 1000 (1 s) | Intervallo di elaborazione [ms] |
| minLogEvents1 | No | STRING | none, info, action, service, warning, alarm, error, fatal | warning | Livello di gravità a partire dal quale un evento monitorato viene scritto anche nel file di log. none disattiva la registrazione |
| logReleased1 | No | BOOLEAN | false, true | false | Registra anche la fine di un allarme, non solo la sua comparsa |
| debugMask1 | No | INTEGER | STRING | Maschera di bit | 0 | Abilita singole uscite diagnostiche del modulo. Solo per sviluppo e ricerca guasti |
| globalMetadata | No | JSON Object | EMPTY JSON Object | Oggetto JSON con metadati qualsiasi specificati dall'utente | |
| globalSnapshot | No | JSON Array of STRING | EMPTY JSON Array | JSON Array che contiene un elenco globale di canali, i cui valori devono essere rilevati puntualmente al momento dell'allarme | |
| snapshotGroups | No | JSON Array of JSON Object | EMPTY JSON Array | vedere sotto | |
| (obsoleto) | Vedere la descrizione dei Messages | ||||
| messages | SÌ | JSON Array of JSON Object | NESSUN valore predefinito | vedere sotto | |
| per Error-Stream o Error-Table | |||||
| sourceErrorCode | No/Sì3 4 | STRING | NESSUN valore predefinito | canale smartCORE, letto come <string>, che contiene un codice di errore variabile nel tempo | |
| sourceErrorLevel | No/Sì3 | STRING | NESSUN valore predefinito | canale smartCORE, letto come <integer>, che contiene un livello di errore sincrono ad esso | |
| neutralErrorLevel | No3 (obsoleto) | INTEGER | 0 | Livello di errore neutro per il quale NON viene attivato alcun allarme | |
| sourceBufferTransfer | No/Sì4 | STRING | NESSUN valore predefinito | canale smartCORE, letto come <bool>, che controlla il framing per la trasmissione della tabella degli errori | |
| timeoutBufferTransfer | No/Sì4 | DOUBLE | 0 | Pausa minima tra le trasmissioni delle tabelle degli errori in secondi |
Gruppi snapshot globali "snapshotGroups"
Più canali da acquisire nell'ambito di uno snapshot possono essere configurati sotto forma di gruppo snapshot come oggetto JSON, il cui nome può poi essere utilizzato nel seguito della configurazione, in gruppi ed elenchi di segnali, come un nome di canale. È opportuno denominare questi gruppi in modo che non avvenga alcuna sovrascrittura di nomi di canale esistenti, poiché un nome in un elenco di segnali viene verificato per primo, nell'interpretazione, come nome di gruppo.
Se nomi di canale sono contenuti in gruppi o elenchi di segnali diversi e quindi moltiplicati, nella composizione dello snapshot vengono inclusi in esso una sola volta.
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| name | SÌ | STRING | Nome o alias del gruppo snapshot | ||
| channels | SÌ | JSON Array of STRING | Elenco di tutti i nomi di canale o dei gruppi già definiti |
Registrazione degli eventi monitorati
Un evento attivato viene sempre scritto nel database degli allarmi. Indipendentemente da ciò, può comparire anche nel file di log del dispositivo. È l'unica traccia che resta analizzabile senza accesso al database degli allarmi — per un dispositivo sul campo spesso l'unica disponibile in assoluto.
Due parametri globali controllano questa registrazione:
- minLogEvents determina a partire da quale messageLevel un evento viene registrato. Il confronto segue l'ordine
infoactionservicewarningalarmerrorfatal. Il valorenonedisattiva completamente la registrazione. Maiuscole e minuscole sono indifferenti,criticalviene accettato come sinonimo dierror. - logReleased decide se viene registrata anche la fine di un allarme. Con
false(default) compare solo la sua comparsa.
Una riga registrata ha questa forma:
Message[ "Pumpe.Druck" , "Hydraulik" ] ALARM RAISED, ts: 1759395881.400, uuid: ab6ffc2f-…: Druck zu hoch: 214 bar
Essa indica il canale monitorato, il context del messaggio, il livello di gravità, la direzione (RAISED o RELEASED), l'istante dell'evento e — se il messaggio ha potuto essere creato nel database degli allarmi — il suo UUID. Tramite questo UUID la riga di log può essere associata in modo univoco al messaggio nel database e nel cloud. Segue il testo del messaggio già compilato.
Il livello di gravità della riga di log segue quello del messaggio: alarm, error e fatal compaiono come ERROR, warning come WARNING, tutti gli altri come INFO. La fine di un allarme viene sempre registrata come INFO — un cessato allarme non è un avvertimento, per quanto forte fosse l'allarme stesso.
Un allarme già presente e nuovamente confermato non viene registrato una seconda volta. Altrimenti una singola condizione permanentemente presente allungherebbe il file di log di una riga a ogni intervallo di elaborazione.
Con logReleased: false non è possibile riconoscere nel file di log se un allarme è ancora presente. Una condizione che oscilla tra comparsa e fine appare allora come una sequenza di allarmi sempre nuovi. Per valutare un segnale oscillante logReleased va impostato su true.
Uscita diagnostica del modulo "debugMask"
Il parametro globale debugMask abilita singole uscite diagnostiche del modulo. Ogni bit rappresenta un tipo di uscita, così che si può porre una domanda senza che la risposta si perda tra le altre dodici. Il default è 0: il modulo non emette nulla che non abbia comunque da segnalare.
| Bit | Uscita |
|---|---|
0x00000001 | Quale monitoraggio si trova su quale canale sorgente, con il relativo tipo di dati e unità |
0x00000002 | I metadati per ogni monitoraggio, risultanti dall'unione di indicazioni globali e locali |
0x00000004 | Il ciclo di elaborazione: timestamp e monitoraggi serviti |
0x00000008 | Il percorso di un messaggio di allarme attraverso il modulo, tracciabile tramite il suo Id interno |
0x00000100 | Snapshot: i gruppi risolti e l'elenco globale dei canali |
0x00000200 | Snapshot: per ogni messaggio l'indice, i canali coinvolti e la finestra temporale |
0x00000400 | Snapshot: i valori acquisiti stessi |
0x00000800 | Snapshot: canali senza dati nella finestra temporale e superamento del tempo di attesa |
0x00010000 | ErrorCode: ogni codice di errore in ingresso con il suo timestamp |
0x00020000 | ErrorCode: la classificazione di un codice — livello e stato risultante |
0x00040000 | ErrorCode: quale messaggio ha prelevato quali codici e quanti restano non elaborati |
0x00080000 | ErrorCode: codici che non sono stati prelevati da alcun messaggio |
0x00100000 | Error-Table: lo stato del canale di trasferimento e il suo superamento del tempo |
La maschera viene accettata come numero JSON o come stringa. Come stringa è ammessa qualsiasi notazione usuale in smartCORE, anche con ' come separatore delle migliaia:
"debugMask": 66048
"debugMask": "0x00010200"
"debugMask": "0b0000'0001'0000'0010'0000'0000"
"debugMask": "10200h"
"debugMask": "~0"
Valori negativi, decimali e valori troppo ampi vengono rifiutati; la maschera resta allora a 0 e il modulo scrive un avvertimento nel file di log.
L'uscita diagnostica è pensata per lo sviluppo e la ricerca guasti ed esclusivamente per un funzionamento di breve durata sotto supervisione.
Diversi bit scrivono una riga per ogni campione o per ogni ciclo di elaborazione. Su un canale veloce il file di log cresce così di un multiplo delle sue dimensioni abituali — su un dispositivo con scheda SD non è solo una questione di spazio, ma anche di durata del supporto di memoria. Le uscite compaiono come righe DEBUG.
La maschera va quindi impostata in modo mirato — solo i bit che riguardano la domanda aperta — e rimossa di nuovo dopo la misura. In una configurazione che funziona in permanenza sul campo, debugMask non deve comparire.
Configurazione dei messaggi di allarme "messages"
I messaggi di allarme "messages" vengono configurati sotto forma di oggetti JSON e in modo diverso a seconda del tipo di monitoraggio.
La scelta dei parametri determina quale tipo di monitoraggio viene eseguito. La tabella seguente lo riassume. Non appena viene utilizzato un parametro indicato, la funzione corrispondente viene attivata:
| Monitoraggio come... | Parametri per l'attivazione | Obbligatorio | Altri parametri raccomandati | Nota |
|---|---|---|---|---|
| ErrorCode | isTemplate errorCode | No No | Ignora channelName, poiché la fonte dei dati è Error-Stream/-Table, activation := HIGH Nessuna funzione di filtro | |
| Double | threshold hysteresis | Sì (obsoleto) Sì | channel activation stabilizationSecondsRaise stabilizationSecondsRelease | Hysteresis è sempre |
| Integer | startBit numberOfBits valuesWhite valuesBlack valuesHigh valuesLow | No No No No Raccomandato Raccomandato | channel activation stabilizationSecondsRaise stabilizationSecondsRelease | Con numberOfBits == 1 il bit selezionato viene trattato come nella modalità Boolean. |
| String | regxWhite regxBlack regxHigh regxLow | No No Raccomandato Raccomandato | channel activation stabilizationSecondsRaise stabilizationSecondsRelease | Se regxWhite definisce sottoespressioni, queste vengono estratte per tutti i test successivi e collegate con ';'. |
| Boolean | channel activation stabilizationSecondsRaise stabilizationSecondsRelease |
Parametri di configurazione comuni
Indipendentemente dal tipo di monitoraggio, per i Messages sono definiti i seguenti parametri:
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| messageLevel | SÌ | STRING | info, action, service, warning, alarm, error, fatal | NESSUN valore predefinito | Grado di gravità del messaggio di allarme |
| context | SÌ | STRING | Contesto del messaggio di allarme Testo statico per l'identificazione di un messaggio | ||
| channel | SÌ/No7 | STRING | Nome del canale smartCORE monitorato | ||
| activation | SÌ | STRING | low, high, minimum, maximum, positiveEdge, negativeEdge, enumCode | high | Tipo di attivazione dell'allarme. |
| messageEvent | No | STRING | Messaggio di allarme quando l'allarme viene attivato. Per contenuti dinamici del messaggio possono essere utilizzati segnaposto. | ||
| needAcknowledge | No | BOOLEAN | false, true | false | è necessaria una conferma lato cloud |
| keepAcknowledgedStatus | No | BOOLEAN | false, true | false | lo stato confermato deve essere mantenuto |
| metadata | No | JSON Object | EMPTY JSON Object | Metadati definiti dall'utente, che possono potenzialmente sovrascrivere i metadati globali | |
| snapshot | No | JSON Array of STRING | EMPTY JSON Array | canali da acquisire durante la prima comparsa della condizione di allarme. Viene unito lo snapshot globale "globalSnapshot" con i gruppi snapshot specificati e risolti qui (da "snapshotGroups") nonché con i canali specificati qui individualmente. | |
| debugMask1 | No | INTEGER | STRING | Maschera di bit | 0 | Abilita singole uscite diagnostiche di questo singolo monitoraggio. Solo per sviluppo e ricerca guasti |
| Se la funzione di filtro è disponibile: | |||||
| stabilizationSecondsRaise | No | INTEGER | 1 - | 0 | Ritardo di stabilizzazione dopo il quale l'allarme deve essere attivato (viene segnalato l'istante iniziale della prima comparsa della condizione di allarme) |
| stabilizationSecondsRelease | No | INTEGER | 1 - | 0 | Ritardo di stabilizzazione dopo il quale l'allarme deve essere disattivato (viene segnalato l'istante iniziale della prima comparsa della condizione di disattivazione) |
| Se può essere generato un evento di errore: | |||||
| messageFailure | No | STRING | Messaggio di allarme quando la condizione di allarme non è valida. Per contenuti dinamici del messaggio possono essere utilizzati segnaposto. |
Configurazione dell'attivazione: activation
Per l'attivazione dell'allarme sono selezionabili i seguenti valori:
| Valore enum | Alias | Significato | Nota |
|---|---|---|---|
| low | Attivazione finché la fonte fornisce LOW | La modalità Double monitora il minimo | |
| high, (Default) | Attivazione finché la fonte fornisce HIGH | La modalità Double monitora il massimo | |
| minimum | min | Attivazione finché la fonte fornisce LOW con aggiornamenti | La modalità Double monitora il minimo con aggiornamento |
| maximum | max | Attivazione finché la fonte fornisce HIGH con aggiornamenti | La modalità Double monitora il massimo con aggiornamento |
| negativeEdge | negEdge | Il passaggio da HIGH->LOW attiva | Messaggio come evento senza stato8 |
| positiveEdge | posEdge | Il passaggio da LOW->HIGH attiva | Messaggio come evento senza stato8 |
| enumCode | enum | Attivazione finché la fonte fornisce HIGH con aggiornamenti | Le modalità Integer/String aggiornano ciascuna per il nuovo codice di errore |
Segnaposto per i testi dei messaggi
Nei testi dei messaggi messageEvent, messageFailure possono essere utilizzati i seguenti segnaposto, per integrare dinamicamente il testo con valori attuali a ogni evento o a ogni aggiornamento. Nel caso di messaggi ErrorCode con template, determinati segnaposto possono essere sostituiti anche in context, quando il codice di errore viene registrato per la prima volta.
| Segnaposto | sostituito da | Esempio |
|---|---|---|
${channel} | Nome del canale del Message | someChannelName |
${unit} | Unità fisica del canale | °C |
${value}9 | Il valore dei dati attuale del canale | 3.14159 |
${date} | La data dell'evento, YYYY-MM-DD | 2026-12-31 |
${time} | L'ora dell'evento, hh:mm:ss | 18:05:27 |
${errorCode}10 | Il codice di errore che ha attivato l'allarme | ERR:243:881 |
${errorLevel}10 | Il livello di errore che ha attivato l'allarme | 8 |
${boundary}11${raiseBoundary}11 | Valore limite impostato per l'attivazione threshold | 10.0 |
${releaseBoundary}11 | Valore limite per la disattivazione threshold hysteresis | 8.5 |
${minmax}11 | Ultimo valore estremo dall'evento oppure, se non determinato: | 17.9 (n.a.) |
${minmaxDate}11 | Data del valore estremo oppure, se non assegnata: | 2026-12-31 (n.a.) |
${minmaxTime}11 | Ora del valore estremo oppure, se non assegnata: | 18:12:35 (n.a.) |
Tutti gli altri segnaposto ${...}, ed eventualmente quelli non disponibili, vengono sostituiti da "(n.d.)".
Uscita diagnostica di un monitoraggio "debugMask"
La debugMask globale risponde alla domanda su cosa fa il modulo. La maschera omonima in una voce di messages risponde alla domanda su cosa fa un singolo monitoraggio — la traccia di un sospetto, senza che gli altri venti scrivano anch'essi. Le due maschere sono indipendenti l'una dall'altra e hanno bit propri; anche qui il default è 0.
| Bit | Uscita |
|---|---|
0x00000001 | Ogni campione elaborato con timestamp, stato di attivazione e indicatore di aggiornamento |
0x00000002 | Il risultato della valutazione dell'attivazione |
0x00000004 | I cambi di stato del filtro di stabilizzazione |
0x00000008 | Il ciclo del filtro senza nuovi dati — la stabilizzazione prosegue anche senza campioni |
0x00000010 | La decisione di considerare una condizione ricomparsa come persistenza |
0x00000020 | Lo stato di errore di un monitoraggio e il suo ripristino automatico |
0x00000040 | Se il messaggio viene gestito con o senza stato memorizzato |
0x00000080 | Il testo del messaggio finito dopo l'inserimento dei segnaposto |
0x00000100 | La coda di uscita dei messaggi: inserito, prelevato, lunghezza |
0x00000200 | Lo snapshot di questo messaggio: indice richiesto e restituzione |
0x00010000 | Il canale sorgente: ogni operazione di lettura dell'accesso al canale |
0x00020000 | Il canale sorgente: verifica dell'avanzamento monotono dei timestamp |
La maschera accetta le stesse notazioni della maschera globale.
Gli ultimi due bit non vengono valutati dal monitoraggio stesso, ma inoltrati all'accesso al canale del suo canale sorgente. Questo accesso è condiviso da tutti i monitoraggi dello stesso canale — i due bit valgono quindi per il canale, non per il singolo messaggio.
Vale la stessa limitazione della maschera globale: uscita diagnostica solo per breve tempo e sotto supervisione. Il bit 0x00000001 scrive una riga per ogni campione — su un canale a 1 kHz sono 3,6 milioni di righe all'ora. Per la domanda su cosa è stato segnalato, il bit 0x00000080 è la scelta giusta: scrive una volta per evento anziché una volta per campione.
Monitoraggio del valore del canale come Boolean
Il monitoraggio come valore Boolean viene impostato quando nell'oggetto Messages non vengono aggiunti parametri individuali. Il canale fornisce direttamente i valori true (HIGH) e false (LOW). Il parametro activation determina con quale livello o con quale fronte il messaggio viene attivato.
Monitoraggio del valore del canale come Double
Nell'ambito del monitoraggio numerico del valore di un canale smartCORE, l'oggetto di configurazione in messages viene integrato con i parametri threshold o hysteresis. Il parametro activation determina se il limite threshold deve essere letto come minimo o massimo e, di conseguenza, se l'hysteresis per il ritorno nell'area non critica deve trovarsi al di sotto o al di sopra del limite.
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| threshold | SÌ | FLOAT | 0 | Soglia il cui superamento o scostamento al di sotto porta al soddisfacimento iniziale della condizione di allarme | |
| hysteresis | SÌ | FLOAT | low, high, minimum, maximum | 0.5 | Zona al di sotto/al di sopra del valore limite in cui viene mantenuto l'ultimo stato. |
| activation | SÌ | STRING | low, high, minimum, maximum | HIGH | Stabilisce se il valore limite deve essere letto come minimo o massimo e se deve avvenire un tracking del valore estremo con nuova segnalazione. |
Monitoraggio del valore del canale come Integer
Se l'oggetto di configurazione in messages viene integrato con almeno uno dei seguenti parametri individuali, il canale da monitorare viene letto come <integer>. Opzionalmente da questo valore può essere estratto, per l'ulteriore elaborazione, un gruppo di bit di lunghezza impostabile. Questo valore viene filtrato e interpretato come codice di stato o valore ENUM:
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| startBit | No | INTEGER | 0..63 | 0 | Definisce uno spostamento a destra del valore Integer prima dell'analisi. |
| numberOfBits | No | INTEGER | 1..64 0: nessun mascheramento | 0 | Maschera dalla parola di stato il corrispondente numero di bit per l'analisi. Il valore mascherato è senza segno per numberOfBits . Se numberOfBits == 1, l'ulteriore elaborazione del bit avviene come Boolean. |
| valuesWhite | No | STRING12 | (vuoto) | Intervalli di valori ammessi per l'analisi, i valori non contenuti vengono ignorati. | |
| valuesBlack | No | STRING12 | (vuoto) | Intervalli di valori non ammessi per l'analisi, i valori contenuti vengono ignorati. | |
| valuesLow | A SCELTA | STRING12 | (vuoto) | Specifica degli intervalli di valori che corrispondono a una condizione di allarme disattivata | |
| valuesHigh | A SCELTA | STRING12 | (vuoto) | Specifica degli intervalli di valori che corrispondono a una condizione di allarme attivata | |
| activation | SÌ | STRING | high enum | HIGH | Tipo di attivazione dell'allarme |
Prima che i valori del canale vengano sottoposti a una valutazione, possono essere filtrati opzionalmente tramite la white list o la black list. Vengono elaborati solo i valori contenuti nell'elenco valuesWhite. Vengono ignorati tutti i valori esclusi nell'elenco valuesBlack.
Possono essere utilizzate a scelta una oppure entrambe le specifiche di intervalli di valori citate sopra, valuesLow o valuesHigh. Se viene utilizzata una sola specifica, ad es. valuesHigh, tutti gli altri valori vengono assegnati automaticamente al contrario, qui ad es. LOW. Se invece vengono utilizzate entrambe le specifiche, gli intervalli di valori non coperti corrispondono a una condizione di allarme non valida. Per questo caso può essere specificato un messaggio di allarme non valido con il testo messageFailure.
Monitoraggio del valore del canale come String
Se l'oggetto di configurazione in messages viene integrato con almeno uno dei seguenti parametri individuali, il canale da monitorare viene interpretato come <string> (testo), ad es. come voce del registro di bordo di un sottosistema:
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| regxWhite | No | STRING13 | (vuoto) | Espressione regolare che verifica i testi e le formattazioni ammessi. | |
| regxBlack | No | STRING13 | (vuoto) | Espressione regolare che determina i testi da ignorare. | |
| regxLow | A SCELTA | STRING13 | (vuoto) | Espressione regolare che descrive lo stato LOW | |
| regxHigh | A SCELTA | STRING13 | (vuoto) | Espressione regolare che descrive lo stato HIGH | |
| activation | SÌ | STRING | high enum | HIGH | Tipo di attivazione dell'allarme |
Prima che i valori del canale vengano sottoposti a una valutazione, possono essere filtrati opzionalmente tramite le espressioni white o black. Vengono elaborati solo i testi che corrispondono all'espressione regxWhite. Vengono ignorati tutti i valori che corrispondono all'espressione regxBlack.
Se regxWhite contiene sottoespressioni (termini in (...)), queste vengono estratte in caso di corrispondenza e collegate tra loro con ';' per tutte le analisi successive. Ciò semplifica l'ulteriore interpretazione, poiché gli elementi chiave sono già estratti dal contesto spesso complesso.
Esempio:
"regxWhite": "Level:([A-Z]+),\\s+(.*)$"
"regxHigh" : "(ERROR|WARNING);"
Estrae da una riga del registro di bordo:
2345987.3256346, abcDevice, Level:ERROR, Here some message!
gli elementi "ERROR" e "Here some message!". L'ulteriore verifica avviene per il testo "ERROR;Here some message!". regxHigh può ora verificare semplicemente i due codici di errore ammessi.
Possono essere utilizzate a scelta una oppure entrambe le espressioni citate sopra, regxLow o regxHigh. Se viene utilizzata una sola espressione, ad es. regxHigh, tutti gli altri valori vengono assegnati automaticamente al contrario, qui ad es. LOW. Se invece vengono utilizzate entrambe le espressioni, i pattern non coperti corrispondono a una condizione di allarme non valida. Per questo caso può essere specificato un messaggio di allarme non valido con il testo messageFailure.
Monitoraggio dei codici di errore: ErrorCode
I dispositivi che controllano impianti o parti di impianto possono comunicare all'esterno i propri stati di errore in diverse forme:
-
Sotto forma di singoli codici, ciascuno combinato con lo stato "Entra" o "Esce"
-
Sotto forma di tabelle di codici di errore trasmesse integralmente (memoria errori) dei codici ancora presenti. In questo caso si deve stabilire per osservazione quali singoli codici "entrano" (sono stati aggiunti) o "escono" (non sono più contenuti). La trasmissione della tabella viene indicata da un segnale di controllo oppure conclusa da un timeout dopo l'ultimo codice di errore.
L'esempio nel diagramma seguente mostra ciò per i codici di errore 17, 42, B7 e E8. Per la massima flessibilità possibile, i codici sul canale sourceErrorCodes vengono sempre letti ed elaborati come <string>.
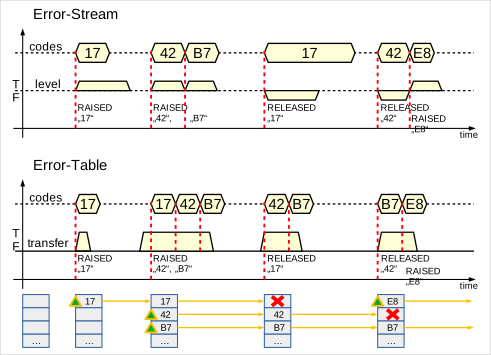
Il modulo Diagnostics legge centralmente i canali
-
sourceErrorCode e sourceErrorLevel, per interpretare un Error-Stream oppure
-
sourceErrorCode e sourceBufferTransfer, per seguire la trasmissione di tabelle di codici di errore.
Per questi canali non devono essere configurati filtri di riduzione dei dati alla fonte. I timestamp svolgono un ruolo decisivo per la localizzazione e la sincronizzazione dei dati!
In linea di principio è determinante per l'interpretazione il timestamp del codice di errore nel canale sourceErrorCode. Il canale sourceErrorLevel deve fornire il livello corrispondente con timestamp esattamente identici. Viene letto come <integer> e confrontato con il neutralErrorLevel ("esce") per determinare lo stato di attivazione.
Il livello del canale sourceBufferTransfer deve passare a true al più tardi con il primo codice di errore di una tabella e deve tornare a false **dopo l'**ultimo codice della tabella. La velocità di trasmissione o l'ordine dei codici di errore non ha alcuna importanza. In alternativa al canale di controllo può essere utilizzato anche un intervallo di tempo timeoutBufferTransfer. La trasmissione della tabella viene considerata completa se, in questo intervallo dopo il presunto ultimo ErrorCode, non arrivano altri ErrorCode.
Se l'oggetto di configurazione in messages viene integrato con almeno uno dei seguenti parametri individuali, i corrispondenti "messages" accedono a questi codici di errore nell'ordine della definizione. In tal caso può essere osservato e segnalato un determinato codice di errore oppure, come template, un gruppo di codici o semplicemente tutti i codici (rimanenti). Per ogni singolo codice viene creato automaticamente un proprio messaggio di allarme, che tiene aggiornato lo stato Entra/Esce. Possono essere utilizzati elementi di testo per configurare in modo dinamico il contesto iniziale e i testi dei messaggi.
| Nome del parametro | Obbligatorio | Tipo di dati | Intervallo di valori sensato | Valore predefinito | Descrizione |
|---|---|---|---|---|---|
| errorCode | A SCELTA | STRING | (vuoto) | Codice di errore monitorato da questa unità di monitoraggio, eventualmente come testo WildMask, se isTemplate è impostato. (vuoto) corrisponde a "*" | |
| isTemplate | A SCELTA | BOOLEAN | false, true | false | Viene impostato quando questa voce Message deve generare dinamicamente e automaticamente voci di messaggio per i codici di errore corrispondenti. |
Informazioni sul modulo
| Informazione | Valore |
|---|---|
| Autori | optiMEAS GmbH |
| da smartCORE | 2.6 |
| Tipo di modulo | Consumer |
| Dipendenze | NESSUNA |