Descrizione del formato OSF
Descrizione generale del formato OSF
- Valida per le versioni del formato 4 e 5 -
L'Open Streaming Format (OSF) è un formato di dati binario, orientato ai blocchi, per la registrazione continua di dati di misura e di processo riferiti al tempo. È concepito per essere ottimale non solo per lo streaming su sistemi embedded con risorse limitate, ma anche per l'elaborazione efficiente a blocchi di grandi quantità di dati su piattaforme di analisi ad alte prestazioni – su server, PC o nel post-processing direttamente su dispositivi embedded.
Principi fondamentali
- Il tempo come asse centrale: tutti i dati vengono memorizzati con informazioni temporali univoche – equidistanti con una griglia temporale fissa oppure singolarmente con timestamp.
- Compatibile con lo streaming: i dati possono essere scritti nel file in modo continuo durante la misura in corso, senza conoscere in anticipo la quantità totale.
- Robustezza: anche in caso di interruzione dell'alimentazione o di spegnimento imprevisto, tutti i dati memorizzati fino all'ultimo blocco scritto rimangono leggibili.
- Struttura aperta: combinazione di un metablock chiaro (XML in OSF4, JSON in OSF5) e di un semplice flusso di dati binario.
- Memorizzazione a blocchi: invece di scrivere i singoli valori in sequenza, vengono utilizzati blocchi di dati. Ciò riduce le operazioni di scrittura e consente un caricamento rapido di grandi quantità di dati.
- Flessibilità: supporto di diversi tipi di dati – dai semplici scalari ai vettori e alle matrici fino ai dati binari come immagini o file audio.
- Metadati: ogni canale può essere descritto con nomi, unità fisiche, dimensioni e informazioni aggiuntive opzionali.
Struttura di base di un file OSF
Indipendentemente dalla versione 4 o 5, ogni file OSF segue lo stesso schema di base:
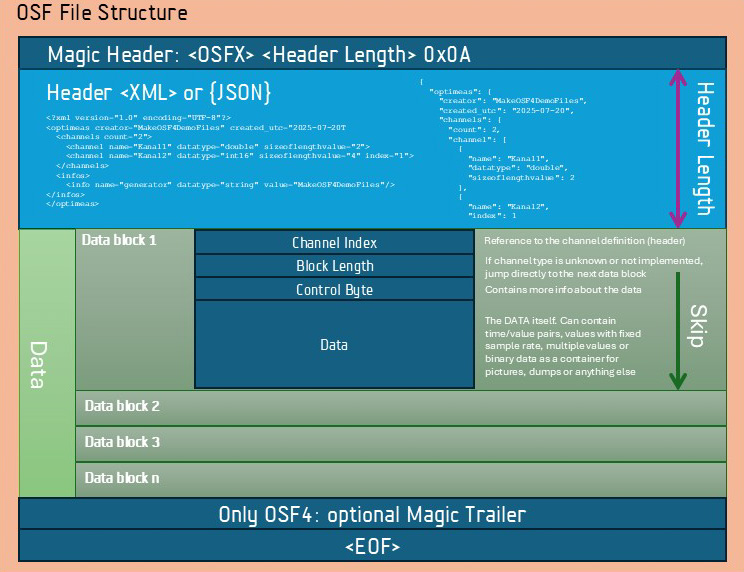
-
Magic header
- Identificatore del formato (OSF4, OSF5, OCEAN_STREAM_FORMAT4, OCEAN_STREAMING_FORMAT4)
- Indicazione della lunghezza del metablock successivo
-
Metablock (XML o JSON)
- Contiene informazioni su canali, tipi di dati, unità fisiche e dati di contesto
- Definisce la struttura dei blocchi di dati successivi
-
Blocchi di dati binari
- Contengono i veri e propri valori di misura nel formato di streaming
- Supportano dati equidistanti e con timestamp
- Possono contenere valori singoli, vettori, matrici o dati binari
-
Blocco di chiusura opzionale
- In OSF4 trailer XML opzionale con statistica e panoramica dei canali
- In OSF5 questo trailer è assente per impostazione predefinita
Organizzazione dei dati
- Canali: ogni flusso di dati viene descritto come un canale che contiene nome, tipo di dato, unità fisica e, opzionalmente, ulteriori attributi.
- Base temporale: tutte le indicazioni temporali vengono memorizzate in nanosecondi dall'epoch e consentono una sincronizzazione di altissima precisione.
- Header del blocco: ogni blocco di dati inizia con un indice del canale e un'indicazione di lunghezza, in modo che il flusso rimanga interpretabile anche in presenza di canali sconosciuti o di interruzioni.
- Byte di controllo: definisce il tipo e la struttura del blocco di dati successivo (ad es. avvio, prosecuzione, tipo di timestamp). In OSF5 l'uso di questo byte è semplificato, ma rimane funzionalmente compatibile.
Magic header
Ogni file OSF inizia con il cosiddetto magic header. Ha due scopi:
- Identificazione univoca come file OSF.
- Indicazione della lunghezza del metablock successivo, in modo che possa essere letto e analizzato direttamente.
Struttura
Il magic header è una riga ASCII, terminata con un linefeed (\n).
Esempio OSF4:
OSF4 173762\n
- OSF4 è l'identificatore del formato.
- 173762 indica la lunghezza del metablock in byte.
Esempio OSF5:
OSF5 84512\n
- OSF5 contrassegna la nuova versione.
- 84512 Il numero indica la lunghezza del metablock, che in OSF5 è per impostazione predefinita JSON.
Identificatori supportati
Per ragioni di compatibilità, le implementazioni OSF riconoscono più header:
- OSF4 – classico file OSF4
- OCEAN_STREAM_FORMAT4 – identificatore legacy per file OSF4, ancora scritto nei dispositivi in commercio; deve essere supportato dai reader
- OCEAN_STREAMING_FORMAT4 – grafia storica meno recente; da interpretare anch'essa come OSF4
- OSF5 – file OSF5
Token di header (campi aggiuntivi opzionali)
La riga di header OSF5 PUÒ contenere, dopo la lunghezza del metablock, token opzionali separati da spazi:
header-line = identifier SP metablock-len *(SP token) LF
token       = key ":" value
Qui key è composta da lettere minuscole a-z, cifre 0-9 e dal trattino
-; value sono caratteri visibili senza spazi. Tra i campi c'è esattamente
uno spazio; prima del LF finale non c'è alcuno spazio.
I token sono «must understand»: se un reader incontra una key che non
conosce, DEVE rifiutare il file — con una diagnostica come
unknown header token '<key>', non come errore di parsing numerico.
I token sono una caratteristica solo OSF5: gli identificatori legacy OSF4 (OSF4,
OCEAN_STREAM_FORMAT4, OCEAN_STREAMING_FORMAT4) NON DEVONO contenere token;
un token dopo un identificatore OSF4 indica un file difettoso.
Le chiavi definite (crc32c, ed25519) e il loro significato sono stabiliti nel
profilo di integrità — vedere
Profilo di integrità OSF5.
Riconoscimento del formato del metablock
Se il metablock successivo è in XML o JSON viene stabilito in base al primo carattere dopo l'header:
<→ XML (formato OSF4){→ JSON (formato OSF5)- Altro carattere → errore
Vantaggi
- Avvio rapido: i reader possono estrarre subito il metablock e passarlo al parser corretto.
- Compatibile con lo streaming: non è necessario conoscere la dimensione complessiva del file.
- Retrocompatibile: OSF5 elabora i file OSF4 (inclusi OCEAN_STREAM_FORMAT4 e OCEAN_STREAMING_FORMAT4).
- Implementazione semplice: una riga basta per determinare versione e parser.
Metablock – canali e metadati
Subito dopo il magic header, in ogni file OSF segue il metablock. Contiene tutte le informazioni necessarie per interpretare correttamente i blocchi di dati successivi. Ne fanno parte:
- Parametri del file: informazioni di contesto sul file e sulla sua origine.
- Definizioni dei canali: descrivono ogni flusso di dati con nome, tipo di dato e proprietà fisiche.
- Metadati: informazioni aggiuntive non direttamente legate a un canale (ad es. stato del sistema, commenti, dati di calibrazione).
Il metablock costituisce l'«indice» del file ed è progettato in modo da essere univoco, leggibile da macchina e facilmente estendibile.
Parametri del file (nel metablock)
- created_utc – momento della creazione del file in UTC in formato ISO 8601
- creator –
optionalidentificazione del creatore (ad es. numero di serie del dispositivo, nome del programma, UUID) - created_at_longitude / created_at_latitude / created_at_altitude –
optionalposizione geografica della creazione del file - reason –
optionalmotivo della creazione del file (ad es.BOOT,SEQUENCE,TRIGGERED) - total_seq_no –
veraltetnumero di sequenza assoluto dall'avvio del sistema (a partire da 0) - triggered_seq_no –
veraltetnumero di sequenza relativo dall'ultimo evento di trigger (a partire da 0) - namespacesep –
optionalseparatore per i nomi di canale gerarchici (default".") - tag –
optionaltag libero per la classificazione del file (ad es.preview) - comment –
optionaltesto di commento opzionale
Definizioni dei canali (channel)
Ogni canale descrive un flusso di dati all'interno del file. I parametri sono descritti di seguito
Identificazione e organizzazione
- index Indice univoco del canale all'interno del file (a partire da 0).
- name
Nome del canale, opzionalmente con percorso gerarchico (ad es.
Motor.Temperatur). - reference Riferimento univoco opzionale o UUID per l'identificazione dell'origine dei dati.
Base temporale
-
timeincrement Incremento temporale fisso in nanosecondi per canali equidistanti. Valore = 0 o non impostato → il canale utilizza timestamp individuali.
Nota: il
timeincrementnel metablock è un suggerimento opzionale. Nelle registrazioni ad alta risoluzione o basate su trigger, la frequenza di campionamento esatta spesso non è ancora nota al momento della creazione dell'header. La frequenza di campionamento effettivamente valida viene fornita comedoublein ogni bloccobcStartDatae vale da quel momento per tutti i successivi blocchibcContinuedDatadello stesso canale, finché non viene scritto un nuovo bloccobcStartData. Ciò vale sia per OSF4 sia per OSF5.
Tipi di dati e struttura
-
datatype Tipo di dato dei valori memorizzati (ad es.
bool,int32,double,string,gpslocation). → Una descrizione completa di tutti i tipi di dati e della loro codifica si trova nel capitolo Tipi di dati. -
channeltype Tipo strutturale del canale:
scalar– valori singoli nel tempobinary– blocchi binari arbitrari (ad es. immagini) (vettore e matrice sono descritti in un documento separato) → Una spiegazione dettagliata dei tipi di canale si trova nel capitolo Tipi di canale.
-
sizeoflengthvalue Dimensione dell'indicazione di lunghezza per ogni blocco di dati:
2→ 2 byte (uint16, dimensione massima del blocco ~64 kB)4→ 4 byte (uint32, dimensione massima del blocco ~4 GB) Viene utilizzato per determinare la dimensione del blocco e leggere correttamente i blocchi di dati nello stream. → Una spiegazione approfondita si trova nel capitolo sizeoflengthvalue.
-
mimetype Opzionale, MIME type per canali binari (ad es.
image/jpeg,audio/wav). -
spectrumtype Opzionale, tipo di dati spettrali:
amplitude(default)realImagampPhaseRadampPhaseDeg
Proprietà fisiche
- physicalunit
Opzionale, unità fisica (conforme al SI, ad es.
V,°C). - physicaldimension
Opzionale, descrizione della dimensione fisica (
temperature,pressure, …).
Visualizzazione e informazioni aggiuntive
- displayname Nome visualizzato opzionale per la visualizzazione o la GUI.
- comment Commento opzionale sul canale.
Metadati (info)
I metadati integrano il file con informazioni aggiuntive non legate a un canale. Parametri tipici:
- name – nome dell'informazione
- value – valore (come stringa o tipizzato)
- datatype – tipo del valore (
string,int32,float,binary,gpslocationecc.) - physicalunit – opzionale, unità fisica del valore
I metadati sono liberamente definibili e si prestano per:
- Dati di sistema o di dispositivo
- Commenti e messaggi di stato
- Valori di calibrazione
- Informazioni aggiuntive definite dall'utente
Nota:
bytearrayè un alias dibinary. Entrambe le denominazioni sono valide in OSF4 e OSF5 e vengono interpretate in modo identico dai reader. I writer dovrebbero utilizzare in modo uniformebinarydurante la scrittura;bytearrayrimane leggibile per la retrocompatibilità.
Vantaggi della struttura
- Chiara separazione tra dati e descrizione: il metablock definisce come i dati devono essere interpretati, senza contenere esso stesso valori di misura.
- Autodescrittivo: i file possono essere letti e interpretati senza definizioni esterne.
- Estendibile: nuovi canali, tipi di dati o metainformazioni possono essere aggiunti senza modificare il formato di base.
- Robusto: grazie a indici e indicazioni di lunghezza fissi, il file rimane interpretabile anche quando non tutti i canali sono noti.
Parametri fondamentali della descrizione del canale
I parametri seguenti definiscono la struttura di base di un canale in OSF e determinano come i dati vengono memorizzati e interpretati nel formato di streaming. Sono rilevanti per tutti i canali e costituiscono il fondamento della descrizione del canale.
Tipi di dati (datatype)
Il parametro datatype stabilisce il formato dei dati dei valori di un canale. Ogni valore viene memorizzato in un formato binario esattamente definito.
Tipi di dati supportati e codifica:
| Tipo di dato | Dimensione (byte) | Descrizione |
|---|---|---|
bool | 1 | Vero/Falso (0 = false, 1 = true) |
int8 | 1 | Numero intero con segno |
int16 | 2 | Numero intero con segno |
int32 | 4 | Numero intero con segno |
int64 | 8 | Numero intero con segno |
uint8 | 1 | Numero intero senza segno, intervallo di valori 0 … 255 |
uint16 | 2 | Numero intero senza segno, intervallo di valori 0 … 65 535 |
uint32 | 4 | Numero intero senza segno, intervallo di valori 0 … 4 294 967 295 |
uint64 | 8 | Numero intero senza segno, intervallo di valori 0 … 18 446 744 073 709 551 615 |
float | 4 | IEEE 754 Single Precision |
double | 8 | IEEE 754 Double Precision |
string | variabile | Codificato in UTF-8, lunghezza definita dalla dimensione del blocco. Su disco in bcAbsTimeStampData: in OSF4 con byte nullo finale (0x00), in OSF5 senza byte finale – per le regole vedere il riquadro di nota più sotto. Per bcMessageEvent il payload è invece con prefisso di lunghezza e in entrambe le versioni non è mai terminato da null. |
binary (alias: bytearray) | variabile | Sequenze di byte arbitrarie per dati di immagini, audio o altri dati binari con MIME type. La lunghezza massima del blocco è determinata dal campo sizeoflengthvalue del canale. Su disco in bcAbsTimeStampData: in OSF4 con byte nullo finale (0x00), in OSF5 senza byte finale – per le regole vedere il riquadro di nota più sotto. Per bcMessageEvent il payload è invece con prefisso di lunghezza e in entrambe le versioni non è mai terminato da null. |
gpslocation | 24 | Struttura per posizioni GPS (vedere sotto) |
Nota sui tipi interi: i valori interi (
int8,int16,int32,int64,uint8,uint16,uint32,uint64) vengono utilizzati nei file OSF tipicamente per stati, informazioni di stato o valori di contatore, non come valori grezzi scalati di una grandezza fisica. Per questo motivo OSF deliberatamente non prevede parametriscale/offsetper la conversione in valori fisici – le grandezze fisiche vengono memorizzate direttamente comefloatodouble.
Nota sulla terminazione null di string e binary
Nota sulla terminazione null di
stringebinary: Il byte finale0x00nei payloadstringebinaryinbcAbsTimeStampDataè un retaggio storico della serializzazione QtQStringnei dispositivi Optimeas originali. La lunghezza del blocco è già determinata in modo univoco dasizeoflengthvalue, un terminatore null come sentinella è ridondante. Per i dati binari è una trappola attiva: un reader che non rimuove il byte produce output non validi (un file JPEG con un0x00aggiunto non è più un JPEG valido). Viceversa, un reader che su un payload binario OSF5 senza terminatore (un blob ASN.1 che termina legittimamente con0x00, un messaggio Protobuf, una stringa terminata da null memorizzata come binary) elimina un byte, taglia un vero byte di dati. La regola è quindi legata al numero di versione su disco, in modo che né i writer né i reader debbano indovinare.OSF4:
- I writer DEVONO aggiungere dopo ogni payload
stringebinaryinbcAbsTimeStampDataun singolo byte finale0x00.- I reader DEVONO rimuovere incondizionatamente l'ultimo byte del payload — la sua presenza è garantita.
OSF5:
- I writer NON DEVONO aggiungere alcun byte finale. Il payload termina con l'ultimo byte di dati;
sizeoflengthvaluedefinisce la lunghezza esatta.- I reader NON DEVONO rimuovere alcun byte finale. Un
0x00finale viene trattato come un normale byte di dati.La lunghezza utile effettiva è quindi: lunghezza del blocco in OSF5, lunghezza del blocco meno un byte in OSF4. Non esiste alcuna euristica né alcun passaggio di rilevamento della sentinella.
Struttura gpslocation
struct gps_location {
    double latitude;   // Breitengrad
    double longitude;  // Längengrad
    double altitude;   // Höhe
};
Nota: per i canali con
datatype="binary"si raccomanda di definire nel canale il MIME type (mimetype) (ad es.image/jpeg,audio/wav), per poter interpretare i dati in modo univoco. La dimensione massima del blocco è determinata dal parametrosizeoflengthvaluedel canale.
Tipi di canale (channeltype)
Il parametro channeltype definisce l'organizzazione logica dei valori di un canale (la sua forma dei dati). Stabilisce quanti valori vengono memorizzati per blocco di dati e quale struttura hanno tali valori.
Importante:
channeltypeè la forma dei dati, non la modalità di memorizzazione/campionamento. Se un canale è equidistante o con timestamp risulta dal byte di controllo del blocco di dati (bcStartData/bcContinuedData⇒ equidistante;bcAbsTimeStampData⇒ timestamp per valore) insieme atimeincrement— non dachanneltype.equidistantetimestampednon sono quindi valori dichanneltypee non devono essere scritti come tali.
OSF prevede i seguenti tipi di canale (scalar, vector, matrix, binary — vedere anche la descrizione dei campi in Tipi di dati e struttura nonché osf4.md):
scalar
-
Descrizione: Un canale con esattamente un valore per istante. Applicazione tipica: grandezze fisiche continue (temperatura, tensione, pressione) o segnali digitali (ad es. stato della porta).
-
Caratteristiche:
- Ogni blocco di dati contiene uno o più campionamenti con un singolo valore.
- Supporta il campionamento equidistante tramite
timeincrementoppure timestamp individuali per valore. - Tipo di canale più semplice e più utilizzato.
-
Esempio XML (OSF4):
<channelindex="0"name="Sensor.Temperature"channeltype="scalar"datatype="double"physicalunit="°C"/> -
Esempio JSON (OSF5):
{"index": 0,"name": "Sensor.Temperature","channeltype": "scalar","datatype": "double","physicalunit": "°C"}
vector
-
Descrizione: Un canale in cui ogni blocco di dati contiene una sequenza di più valori logicamente correlati. Applicazione tipica: spettri di frequenza (FFT), segmenti di serie temporali, registrazioni multicanale in un blocco.
-
Caratteristiche:
- La lunghezza del vettore può variare da blocco a blocco.
- Riduce l'overhead ad alta frequenza di campionamento, poiché più valori vengono scritti in un blocco.
- Può funzionare sia con timestamp per blocco sia con incremento temporale fisso.
- Richiede parametri aggiuntivi per le informazioni sugli assi (documento separato).
-
Esempio XML (OSF4):
<channelindex="2"name="FFT.Magnitude"channeltype="vector"datatype="float"physicalunit="dB"/> -
Esempio JSON (OSF5):
{"index": 2,"name": "FFT.Magnitude","channeltype": "vector","datatype": "float","physicalunit": "dB"}
matrix
-
Descrizione: Un canale che memorizza per ogni timestamp una struttura di dati bidimensionale. Applicazione tipica: classificazioni rainflow, heatmap, array di sensori 2D, dati di immagine.
-
Caratteristiche:
- La dimensione della matrice può variare da blocco a blocco.
- Consente strutture di dati complesse su una base temporale uniforme.
- Richiede parametri aggiuntivi per la descrizione di righe e colonne (documento separato).
-
Esempio XML (OSF4):
<channelindex="5"name="Rainflow.Matrix"channeltype="matrix"datatype="int32"physicalunit="counts"/> -
Esempio JSON (OSF5):
{"index": 5,"name": "Rainflow.Matrix","channeltype": "matrix","datatype": "int32","physicalunit": "counts"}
binary
-
Descrizione: Un canale che memorizza per ogni istante un blocco binario arbitrario (un blob per valore). Applicazione tipica: immagini, frammenti audio, messaggi serializzati.
-
Caratteristiche:
- Payload equivalente a un canale
scalarcondatatype="binary"; un reader tratta entrambe le notazioni in modo identico. - Si raccomanda di impostare il
mimetypedel canale (ad es.image/jpeg). - La dimensione massima del blocco è determinata da
sizeoflengthvalue.
- Payload equivalente a un canale
-
Esempio JSON (OSF5):
{"index": 3,"name": "Camera.Frame","channeltype": "binary","datatype": "binary","mimetype": "image/jpeg"}
Note su vector e matrix
- Parametri aggiuntivi: entrambi i tipi richiedono metainformazioni su dimensioni, assi, unità fisiche ed eventualmente etichette. Queste sono descritte in dettaglio in documenti dedicati.
- Efficienza: i canali vettoriali e matriciali riducono le operazioni di scrittura e sono particolarmente adatti a dati con alta frequenza di campionamento o struttura complessa.
- Flessibilità: dimensione e struttura dei blocchi possono variare, il che consente l'adattamento a diversi scenari di misura.
- Sincronizzazione: condividono la stessa base temporale dei canali scalar, così che tipi di dati diversi possano essere archiviati in un file in modo esattamente sincronizzato.
Riepilogo
scalar– Tipo di canale semplice, un valore per istante. Ideale per grandezze di misura continue.vector– Più valori in un blocco, ottimizzato per spettri di frequenza e dati ad alta frequenza.matrix– Blocchi multidimensionali, adatti a classificazioni, dati di immagini e di array.binary– Un blocco binario arbitrario per istante (immagini, audio, messaggi serializzati); equivalente ascalar+datatype="binary".
Nota: combinando questi tipi di canale, OSF copre sia segnali semplici sia insiemi di dati complessi e rimane allo stesso tempo facilmente implementabile.
Campo della dimensione del blocco (sizeoflengthvalue)
Il parametro sizeoflengthvalue definisce la dimensione del campo di lunghezza che precede ogni blocco di dati di un canale. Determina quindi quanti byte vengono utilizzati per indicare la dimensione del blocco e, di conseguenza, quanto può essere grande al massimo un singolo blocco di dati.
Scopo
OSF è un formato di streaming. Ogni blocco di dati può avere una dimensione diversa e contiene un numero variabile di valori di misura. Per poter leggere correttamente questi blocchi, la loro lunghezza deve essere nota. Il campo sizeoflengthvalue indica se per l'indicazione di lunghezza vengono utilizzati 2 byte o 4 byte.
Valori
-
2 – il campo di lunghezza è di 2 byte (uint16).
- Valore massimo: 65.535 byte per blocco di dati.
- Valore predefinito per i tipici canali di misura con dimensioni di blocco moderate.
- Minore consumo di memoria e minore overhead.
-
4 – il campo di lunghezza è di 4 byte (uint32).
- Valore massimo: ~4 GB per blocco di dati.
- Adatto a canali con pacchetti di dati molto grandi, ad es. dati di immagini, audio o binari.
Valore predefinito
Se non specificato esplicitamente, viene utilizzato sizeoflengthvalue="2".
Effetti
- Fabbisogno di memoria: 2 byte fanno risparmiare spazio con blocchi piccoli, 4 byte consentono dati di grandi dimensioni.
- Leggibilità: prima di interpretare ogni blocco, il reader deve leggere l'indicazione di lunghezza e trattare i successivi
Nbyte come blocco. - Resistenza agli errori: anche in caso di scrittura interrotta, il reader può saltare correttamente i blocchi e trovare il successivo blocco valido.
Raccomandazioni
- Per segnali continui e canali con valori scalari → utilizzare
2. - Per canali binari con immagini, audio o grandi pacchetti di dati → scegliere
4. - Scelta uniforme per canale; può essere impostata per ciascun canale nella definizione del canale.
Blocchi di dati
I blocchi di dati costituiscono il cuore del formato OSF. Contengono i veri e propri valori di misura e sono strutturati in modo da poter essere scritti e letti in modo efficiente sia nello streaming continuo su sistemi embedded sia nell'elaborazione a blocchi su server e PC. Ogni blocco di dati è autonomo e rimane interpretabile anche in caso di interruzione della registrazione.
Introduzione
In OSF tutti i valori di misura vengono memorizzati in blocchi di dati. Ogni blocco è un'unità autonoma che contiene uno o più valori di un canale ed è collegata a informazioni temporali.
Il concetto di blocco consente due proprietà centrali del formato:
- Streaming continuo: i valori possono essere scritti in modo progressivo durante la registrazione, senza conoscere l'intera struttura del file.
- Elaborazione efficiente: grazie alla memorizzazione a blocchi, grandi quantità di dati possono essere caricate ed elaborate rapidamente su server, PC o nel post-processing.
Ogni blocco di dati è concepito in modo da rimanere leggibile, anche in caso di interruzione improvvisa della misura (ad es. interruzione dell'alimentazione), fino all'ultima unità scritta per intero.
La struttura dei blocchi di dati è identica per OSF4 e OSF5 e costituisce la base per una registrazione robusta e senza perdite di dati di misura riferiti al tempo.
Struttura generale di un blocco di dati
Un blocco di dati in OSF è costituito da una struttura di intestazione fissa, seguita da metadati opzionali e dai veri e propri valori di misura.
La struttura è concepita in modo che ogni blocco possa essere interpretato in modo indipendente e rimanga valido anche in caso di streaming o di interruzione del file.
Struttura di base:
-
Indice del canale (
uint16)- Identifica a quale canale appartengono i dati.
- Corrisponde all'attributo
indexnel metablock.
-
Campo di lunghezza (
uint16ouint32)- Dimensione in byte del contenuto del blocco successivo (byte di controllo e area dati; al livello di integrità OSF5
crcinoltre la CRC di frame finale). - La lunghezza del campo è definita dal parametro del canale
sizeoflengthvalue. - Consente di saltare i blocchi o, in caso di errori, di passare correttamente all'unità successiva.
- Dimensione in byte del contenuto del blocco successivo (byte di controllo e area dati; al livello di integrità OSF5
-
Byte di controllo (
uint8)- Definisce il tipo del blocco di dati e contiene informazioni sulla struttura dei dati successivi.
- Il bit più significativo (bit 7) indica se il blocco contiene un singolo valore (0) oppure più valori/coppie di valori (1).
- Una panoramica completa dei valori del byte di controllo si trova nella sezione Il byte di controllo.
-
Area dati
- I veri e propri valori di misura o blocchi di dati.
- Formato e dimensione dipendono dal tipo di canale (tipicamente scalar) e dal tipo di dato.
Blocchi di dati di lunghezza zero (non conformi)
Questa regola vale allo stesso modo per OSF4 e OSF5 — la struttura dei blocchi è identica in entrambe le versioni del formato.
Ogni blocco di dati contiene almeno il proprio byte di controllo; un campo di
lunghezza letto letteralmente dallo stream con valore 0 non compare quindi mai
in un file conforme. Al livello di integrità OSF5 crc non è mai inferiore a 5,
poiché i quattro byte della CRC di frame sono conteggiati nel campo di lunghezza
(vedere Profilo di integrità OSF5).
- I writer NON DEVONO scrivere alcun blocco di dati con campo di lunghezza
0. - I reader NON DEVONO trattare un campo di lunghezza letto letteralmente come
0come file troncato e NON DEVONO interrompere la lettura. Il blocco è costituito esclusivamente da indice del canale e campo di lunghezza, entrambi già consumati dal reader. Il reader salta il blocco, lo conta come blocco saltato con il motivoZeroLengthBlocke prosegue la lettura al successivo indice del canale. - Il test
0avviene prima del test di lunghezza CRC a ogni livello di integrità. Un campo di lunghezza0viene sempre classificato comeZeroLengthBlock, mai come errore CRC. Una lunghezza da1a4al livellocrcè un blocco difettoso e rimane una questione di CRC, non un blocco nullo. - L'anomalia DEVE essere visibile tramite un contatore dedicato nelle statistiche del reader, in modo che un file non conforme sia diagnosticabile anziché essere accettato in silenzio.
Il reader avanza sempre: ogni blocco di questo tipo consuma 4 o 6 byte
(un indice del canale uint16 più un campo di lunghezza di 2 o 4 byte), una
sequenza di blocchi nulli non può quindi bloccarlo.
Il byte di controllo
Ogni blocco di dati in OSF contiene un byte di controllo (blockContent) che determina il tipo del blocco e la struttura dei dati contenuti.
Inoltre il bit più significativo (bit 7) contiene l'informazione se il blocco contiene solo un singolo valore oppure più valori o coppie di valori:
- Bit 7 = 0 → un singolo valore o una singola coppia di valori nel blocco.
- Bit 7 = 1 → più valori o coppie di valori nel blocco (N > 1).
Il byte di controllo viene interpretato come valore a 8 bit. I 7 bit inferiori definiscono il tipo di blocco, il bit più alto il numero di valori.
Panoramica dei tipi di blocco
| Valore (0–8) | Enum | Significato | Contenuto del blocco di dati |
|---|---|---|---|
| 0 | bcReserved | Riservato per usi futuri. Originariamente bcMetaData, finora non utilizzato. | Variabile, funzioni speciali interne |
| 1 | bcTrustedTimestamp | Entfällt Originariamente pensato per valori costanti con timestamp «valido fino a». Raccomandazione: impostare i punti di appoggio tramite l'applicazione. | int64: timestamp assoluto (ns since Epoch) |
| 2 | bcTimebaseRealign | Entfällt Adattamento dell'asse temporale. Se necessario può essere sostituito scrivendo un nuovo blocco con istante di avvio assoluto. | int64: timestamp assolutoint64: spostamento temporale (ns) |
| 3 | bcStatusEvent | Entfällt Serviva a trasportare informazioni di stato per canale. Non più utilizzato. A differenza di bcMessageEvent, il suo payload è una parola di stato fissa anziché un valore del canale, quindi non viene mai decodificato come campione del canale. I reader DEVONO registrarlo tramite un contatore dedicato, separato dal contatore cumulativo generale dei deprecati, in modo che una sua comparsa sul campo rimanga visibile. | int64: timestamp assolutouint32: parola di stato |
| 4 | bcMessageEvent | Entfällt, muss gelesen werden Viene ancora generato dai dispositivi in uso sul campo per i canali string in OSF4 — lì una codifica ammessa, perché la specifica esclude soltanto che il tipo venga ancora generato a partire da OSF5. Può essere sostituito integralmente da bcAbsTimeStampData con lo stesso datatype. I reader DEVONO decodificarlo come un campione con timestamp del datatype del canale; i writer NON DEVONO generarlo. Il bit 7 non è specificato per questo tipo di blocco e NON DEVE essere interpretato: un reader che lo trova impostato tratta il blocco come sconosciuto, lo salta in base al campo di lunghezza, lo conta e prosegue la lettura (struttura completa del blocco e casi limite più sotto). | int64: timestamp assolutouint32: lunghezza del payload NN byte di payload, interpretati secondo il datatype del canale — definito solo per string e binary (vedere sotto). Nessun 0x00 finale — il payload ha prefisso di lunghezza, quindi la regola di terminazione null OSF4 di bcAbsTimeStampData non si applica. |
| 5 | bcContinuedData | Prosecuzione dei dati con frequenza di campionamento fissa. Con bit 7 impostato più valori nel blocco. | [uint32 N]: numero di campioni (solo se il bit 7 è impostato)N × valori di dati |
| 6 | bcStartData | Primo blocco di dati con frequenza di campionamento fissa; contiene inoltre la frequenza di campionamento valida a partire da questo blocco (ad es. in caso di trigger). Contiene sempre un timestamp di avvio assoluto. | int64: timestamp assolutodouble: frequenza di campionamento (Hz)[uint32 N]: numero di campioni (solo se il bit 7 è impostato)N × valori di dati |
| 7 | bcContinuedRelStampData | Entfällt, In OSF5 beim Lesen unterstützt Originariamente per risparmiare 4 byte per campione con timestamp relativi. | [uint32 N]: numero di campioni (solo se il bit 7 è impostato)N × (uint32 tempo relativo + valore di dati) |
| 8 | bcAbsTimeStampData | Blocchi di dati con timestamp assoluto per valore. Ora supporta anche stringhe e dati binari in combinazione con datatype e mimetype. | [uint32 N]: numero di campioni (solo se il bit 7 è impostato)N × (int64 tempo assoluto + valore di dati) |
Limitazione dei tipi di blocco rispetto alle informazioni del canale:
| Tipo ENUM | Dati equidistanti | Dati con timestamp |
|---|---|---|
| bcStartData | consentito | non consentito |
| bcContinuedData | consentito | non consentito |
| bcContinuedRelStampData | non consentito | consentito |
| bcAbsTimeStampData | non consentito | consentito |
| bcMessageEvent | non consentito | consentito |
Struttura dei dati per tipo di controllo
La struttura dei dati utili in un blocco dipende direttamente dal tipo di controllo.
Le sezioni seguenti descrivono come sono memorizzati i valori per i diversi tipi di dati e quali limitazioni si applicano.
bcStartData (dati equidistanti, blocco iniziale)
-
Utilizzo:
- Inizio di una serie di dati con frequenza di campionamento fissa.
- Contiene sempre l'istante di avvio assoluto della serie.
- Consentito solo per
datatypenumerici (int*,float,double).
-
Struttura del blocco:
int64– timestamp di avvio assoluto (ns since Epoch).double– frequenza di campionamento in Hz (valida da questo blocco fino al successivobcStartData).- [uint32 N] – numero di campioni (solo se il bit 7 è impostato, altrimenti 1).
- N × valori di dati – dati grezzi corrispondenti a
datatype.
-
Esempio
datatype=double: [int64 ZeitStart] [double SampleRate] [uint32 N] [double Wert1] [double Wert2] ... [double WertN] -
Note:
bcStartDatapuò comparire più volte per file e canale. Viene scritto:- all'inizio di una registrazione equidistante,
- a ogni trigger o evento che avvia una nuova sequenza di dati,
- in caso di necessaria correzione della traccia temporale (compensazione della deriva).
- Conseguenza per i reader: i dati di un canale equidistante si generano per blocco o per evento. Tra sequenze consecutive dello stesso canale possono esserci lacune temporali. I reader devono assumere la frequenza di campionamento effettiva dal blocco
bcStartDataattualmente valido e non devono presumere chetimeincrementdel metablock sia sempre corretto.
bcContinuedData (dati equidistanti, prosecuzione)
-
Utilizzo:
- Prosegue una serie iniziata con
bcStartDatasenza nuovo timestamp. - Il primo valore segue direttamente l'ultimo valore del blocco precedente.
- Consentito solo per
datatypenumerici (int*,float,double).
- Prosegue una serie iniziata con
-
Struttura del blocco:
- [uint32 N] – numero di campioni (solo se il bit 7 è impostato, altrimenti 1).
- N × valori di dati – dati grezzi corrispondenti a
datatype.
-
Esempio
datatype=int16:[uint32 N] [int16 Wert1] [int16 Wert2] ... [int16 WertN] -
Nota: il tempo per campione in un blocco
bcContinuedDatarisulta da1 / SampleRatedell'ultimo bloccobcStartDataletto dello stesso canale.
bcAbsTimeStampData (dati con timestamp)
-
Utilizzo:
- Per canali con timestamp individuali per valore.
- Supporta tutti i
datatype, inclusistringebinary.
-
Struttura del blocco:
- [uint32 N] – numero di campioni (solo se il bit 7 è impostato, altrimenti 1).
- N × (int64 tempo + valore di dati) – timestamp assoluto + valore.
-
Esempio
datatype=int16:[uint32 N] [int64 Zeit1] [int16 Wert1] [int64 Zeit2] [int16 Wert2] ... -
Esempio
datatype=double:[uint32 N] [int64 Zeit1] [double Wert1] [int64 Zeit2] [double Wert2] ... -
Esempio
datatype=string:- Le stringhe vengono memorizzate come byte UTF-8 grezzi. La lunghezza effettiva della stringa risulta dalla lunghezza utile del campo dati, meno un byte in OSF4 (il
0x00finale prescritto dalla specifica) oppure la lunghezza utile completa in OSF5 (per le regole complete vedere il riquadro di nota sopra). - Forma a campione singolo (bit 7 = 0, N implicitamente 1): [int64 Zeit] [UTF-8 Bytes des Strings]
- La forma a più campioni (bit 7 = 1) per i tipi a lunghezza variabile non fa parte del formato wire standard; vedere più sotto la nota sui blocchi multi-campione per lunghezze variabili.
- Le stringhe vengono memorizzate come byte UTF-8 grezzi. La lunghezza effettiva della stringa risulta dalla lunghezza utile del campo dati, meno un byte in OSF4 (il
-
Esempio
datatype=binary:- I dati binari vengono scritti come byte grezzi. Il
mimetypenel canale definisce l'interpretazione. La lunghezza effettiva del payload è la lunghezza utile del campo dati, meno un byte in OSF4 (il0x00finale prescritto dalla specifica) oppure la lunghezza utile completa in OSF5 (per le regole complete vedere il riquadro di nota sopra). - Forma a campione singolo (bit 7 = 0, N implicitamente 1): [int64 Zeit] [Byte1] [Byte2] ... [Byte M]
- La forma a più campioni (bit 7 = 1) per i tipi a lunghezza variabile non fa parte del formato wire standard; vedere più sotto la nota sui blocchi multi-campione per lunghezze variabili.
- I dati binari vengono scritti come byte grezzi. Il
Blocchi multi-campione per lunghezze variabili. Per i dati
stringebinaryinbcAbsTimeStampDatai writer devono emettere un campione per blocco (N=1). La forma multi-campione (bit 7 = 1 con N > 1) per i tipi a lunghezza variabile non fa parte del formato wire standard. I reader possono incontrare blocchi multi-campione a lunghezza variabile provenienti da writer più vecchi o non conformi allo standard; il comportamento del reader in questo caso dipende dall'implementazione. I reader di riferimento Rust e C++ accettano esclusivamente layout con segmenti di uguale lunghezza per campione; lo storico writer Delphi utilizza un prefisso di lunghezzauint32per campione, che altri reader non analizzano.
- Nota: con più campioni per blocco (
N>1) i tipi numerici devono avere una dimensione wire fissa per campione. I blocchi multi-campione per lunghezze variabili non sono standard; vedere la nota sui blocchi multi-campione per lunghezze variabili qui sopra.
bcContinuedRelStampData (con timestamp, relativo)
-
Utilizzo:
- Per canali con timestamp individuali e intervalli relativi.
- Non più utilizzato a partire da OSF5, rimane per i reader OSF4.
-
Struttura del blocco:
- [uint32 N] – numero di campioni (solo se il bit 7 è impostato, altrimenti 1).
- N × (uint32 Δt + valore di dati) – intervallo di tempo relativo in ns + valore.
-
Esempio
datatype=int16:[uint32 N] [uint32 Δt1] [int16 Wert1] [uint32 Δt2] [int16 Wert2] ... -
Ulteriori esempi sotto bcAbsTimeStampData
-
Nota:
-
Sviluppato originariamente per risparmiare 4 byte per campione.
-
In OSF5 questo tipo viene meno a favore di un'implementazione più semplice.
bcMessageEvent (deprecato, deve essere letto)
-
Utilizzo:
- Codifica storica per un valore
stringobinarycon timestamp; può essere sostituito integralmente dabcAbsTimeStampDatacon lo stessodatatype. - Viene ancora generato dai dispositivi in uso sul campo per i canali
stringin OSF4 — lì una codifica ammessa, perché la specifica esclude soltanto che il tipo venga ancora generato a partire da OSF5. I reader DEVONO decodificarlo in ogni versione del formato, perché esistono sul campo file contenenti questo blocco. I writer NON DEVONO generarlo.
- Codifica storica per un valore
-
Struttura del blocco:
int64– timestamp assoluto (ns since Epoch).uint32– lunghezza del payload N (byte).Nbyte di payload, interpretati secondo ildatatypedel canale.
-
Esempio
datatype=string: [int64 Zeit] [uint32 N] [N Bytes UTF-8-Nutzlast] -
Nessun
0x00finale. Il payload ha prefisso di lunghezza tramiteN, quindi la regola di terminazione null OSF4 dibcAbsTimeStampData(vedere il riquadro di nota sulla gestione del byte nullo) qui non si applica — non c'è mai stato alcun byte da rimuovere. Viene riutilizzata solo l'interpretazione del valore dei payloadstring/binarydibcAbsTimeStampData, non il loro framing. -
Ambito di
datatype. Solodatatype=stringedatatype=binarysono definiti per questo tipo di blocco. Per qualsiasi altrodatatypei reader DEVONO saltare e contare il blocco in base al suo campo di lunghezza — NON DEVONO generare un errore né interrompere il file. Saltare mantiene leggibile il resto di una registrazione reale; un'interruzione reintrodurrebbe altrove lo stesso tipo di errore eliminato dalla regola sui blocchi nulli. -
N = 0è ammesso e viene decodificato in un valore vuoto (stringa vuota o payload binario di lunghezza 0) – non è un errore. Questa non è l'anomalia dei blocchi di dati di lunghezza zero: lì il campo di lunghezza stesso è0e non viene mai letto alcun byte di controllo; qui il campo di lunghezza corrisponde alla dimensione effettiva del frame (1 + 8 + 4 + Nbyte), solo il payload è casualmente vuoto. -
Il bit 7 (valore multiplo) non è specificato per questo tipo di blocco. Non è mai stato osservato impostato sul campo e per questo tipo di blocco non è definito alcun layout multi-campione. Un reader che lo trova impostato NON DEVE interpretarlo: tratta il blocco come tipo sconosciuto, lo salta in base al campo di lunghezza, lo conta e prosegue la lettura — lo stesso trattamento conservativo di qualsiasi altra forma non riconosciuta.
Limitazioni
-
Canali equidistanti (bcStartData, bcContinuedData):
- Solo tipi di dati numerici diretti (
int*,float,double). - Nessuna stringa, nessun dato binario, nessuna struttura complessa.
- Solo tipi di dati numerici diretti (
-
Canali con timestamp (bcAbsTimeStampData, bcContinuedRelStampData):
- Supportano tutti i tipi di dati.
- Stringhe e dati binari contengono in OSF4 un byte finale
0x00(rimosso dai reader) e in OSF5 nessun byte finale; per le regole deterministiche vedere il riquadro di nota sulla gestione del byte nullo.
Punti importanti
-
Compatibilità:
- OSF5 può leggere tutti i tipi di blocco OSF4.
- A partire da OSF5
bcContinuedRelStampData,bcStatusEventebcMessageEventnon vengono più generati. Non essere più generati non significa non essere più letti:bcContinuedRelStampDataebcMessageEventdevono continuare a essere supportati dai reader in ogni versione, perché esistono sul campo file contenenti questi blocchi. bcTrustedTimestampviene ignorato ed è contrassegnato come deprecated.
-
Implementazione:
- I reader devono sempre verificare il bit 7 per interpretare correttamente i blocchi a valore singolo rispetto a quelli a più valori.
- I tipi di blocco non riconosciuti possono essere saltati in base all'indicazione di lunghezza.
-
Stringhe e dati binari:
- Per
bcAbsTimeStampDatacondatatype=stringodatatype=binaryil byte nullo finale (0x00) è sempre presente in OSF4 (il writer deve aggiungerlo, il reader deve rimuoverlo) e mai presente in OSF5 (il writer non deve aggiungerlo, il reader non deve rimuoverlo). Per le regole complete vedere il riquadro di nota sulla gestione del byte nullo. - La lunghezza del blocco risulta da
sizeoflengthvalue. - I dati binari utilizzano
datatype=binarypiùmimetype.
- Per
Chiusura del file e magic trailer
Alla fine di un file OSF può essere scritto opzionalmente un blocco dati info con lo speciale indice del canale 0xFFFF.
Questo blocco fornisce metainformazioni sul flusso di dati concluso e contrassegna la chiusura regolare del file.
Blocco dati info (indice del canale 0xFFFF)
-
Scopo:
Fornisce una rapida panoramica dell'intervallo di tempo e della segmentazione del file, senza dover leggere tutti i blocchi di dati.
Utile per strumenti di analisi e di indicizzazione. -
Struttura:
uint16– indice del canale (0xFFFF)uint32– lunghezza del successivo blocco di opzioniuint8– byte di controllo (semprebcReserved/ 0)string– blocco info codificato in UTF-8 (formato dipendente dalla versione OSF)
Esempio (OSF4, XML):
<trailer finalized_utc="2019-08-12T12:23:01+02:00" reason="fileStartGrid_min">
    <channels count="8">
        <channel index="0" samples="29452" last_ns="1384899599997800000" last_utc="2019-11-19T23:19:59"/>
        <channel index="1" samples="29452" last_ns="1384899599997800000" last_utc="2019-11-19T23:19:59"/>
        <channel index="2" samples="29452" last_ns="1384899599997800000" last_utc="2019-11-19T23:19:59"/>
        <channel index="3" samples="29452" last_ns="1384899599997800000" last_utc="2019-11-19T23:19:59"/>
    </channels>
</trailer>
Esempio (OSF5, JSON):
{
  "trailer": {
    "finalized_utc": "2019-08-12T12:23:01+02:00",
    "reason": "fileStartGrid_min",
    "channels": [
      {
        "index": 0,
        "samples": 29452,
        "last_ns": 1384899599997800000,
        "last_utc": "2019-11-19T23:19:59"
      },
      {
        "index": 1,
        "samples": 29452,
        "last_ns": 1384899599997800000,
        "last_utc": "2019-11-19T23:19:59"
      }
    ]
  }
}
-
Osservazione:
- OSF4 utilizza per impostazione predefinita XML per il blocco info.
- OSF5 utilizza JSON, ma per ragioni di compatibilità può leggere anche XML, senza però scriverlo.
Magic trailer
Opzionalmente, dopo il blocco dati info può seguire un magic trailer.
Serve come marcatura fissa della chiusura del file e indica dove inizia il blocco 0xFFFF.
- Formato:
OSF_STREAM_END 321316454==============
- Il numero indica la posizione nel file in cui inizia il blocco
0xFFFF. - Il tag del trailer viene riempito fino a 40 byte, con caratteri
=dopo il numero fino al raggiungimento della lunghezza.
Scopo del magic trailer
- Consente di trovare il blocco dati info alla fine del file senza dover scorrere l'intero file.
- Facilita le implementazioni ad accesso casuale e l'indicizzazione di file di grandi dimensioni.
- Offre una marcatura chiara per la chiusura regolare di un file OSF.
Opzionalità e onere di implementazione
-
Scrittura:
- Il blocco info e il magic trailer non sono obbligatori.
- Se vengono scritti, consentono una rapida indicizzazione e la determinazione dell'intervallo di tempo del file.
- Nei sistemi embedded con risorse limitate possono essere omessi.
-
Lettura:
- I parser non devono presupporre la presenza del blocco.
- I file senza trailer vengono interpretati fino all'ultimo blocco completamente leggibile.
- In caso di interruzione brusca l'ultimo blocco può essere più corto della propria indicazione di lunghezza – in tal caso il reader deve interrompere la lettura alla fine del file.
Vantaggi
- Rapida determinazione dell'intervallo di tempo e delle statistiche senza leggere interamente il file.
- Utile per misure lunghe e analisi automatizzata.
- Consente l'accesso casuale per gli strumenti di analisi.
Svantaggi
- Maggiore onere di implementazione per scrittura e lettura.
- In caso di interruzione del file il trailer può mancare o essere incompleto.
- Per un semplice streaming non è strettamente necessario.
OSFZ — File OSF compressi
I file OSF possono essere compressi per l'archiviazione o la trasmissione. I file compressi hanno di solito l'estensione
.osfz e contengono un file OSF completo (OSF4 o OSF5)
come payload compresso. Non esiste un magic header OSFZ proprio
— il riconoscimento avviene in base ai magic byte di compressione all'inizio
del file.
Formati di compressione supportati
I reader devono riconoscere e decomprimere in modo trasparente entrambi i formati di compressione più diffusi:
| Formato | Magic byte | Specifica |
|---|---|---|
| gzip | 0x1F 0x8B | RFC 1952 |
| zlib | 0x78 0x01, 0x78 0x5E, 0x78 0x9C, 0x78 0xDA | RFC 1950 |
Entrambi i formati sono validi nella pratica: i dispositivi Optimeas scrivono attualmente file OSFZ compressi con gzip; strumenti più vecchi e pipeline di storage utilizzano zlib. Un'implementazione che supporti solo uno dei due formati non sarebbe in grado di leggere i file reali sul campo.
Riconoscimento
Il riconoscimento avviene tramite i primi due byte del file:
0x1F 0x8B→ decompressione gzip0x78 0x01 / 0x5E / 0x9C / 0xDA→ decompressione zlib- altrimenti → non compresso, leggere il file direttamente come OSF
Dopo la decompressione il file inizia con un normale
magic header OSF (OSF4, OSF5, OCEAN_STREAM_FORMAT4 oppure
OCEAN_STREAMING_FORMAT4).
Scrittura
I writer possono generare output OSFZ. Come formato di compressione viene utilizzato gzip (RFC 1952).
I writer in streaming (che scrivono i blocchi in modo incrementale con fsync
per blocco) devono trattare la compressione come un passo a valle dopo la
finalizzazione, separato dal vero e proprio percorso di scrittura. Una
compressione inline renderebbe impossibile la decompressione in caso di interruzione
dell'alimentazione e successivo troncamento, vanificando la durabilità best-effort.
Il passo di compressione viene eseguito dopo la chiusura del writer —
o come thread in background a bassa priorità (il processo può terminare solo
quando questo è concluso) oppure come processo CLI esterno. Il file OSF
sorgente deve essere conservato finché il file OSFZ non è stato scritto con successo
e sottoposto a fsync; una verifica tramite rilettura
non è necessaria prima della cancellazione.
I writer a blocchi (che memorizzano l'intero file in memoria e lo scrivono in modo atomico) possono scrivere direttamente in forma compressa e generare file OSFZ inline, poiché non sussiste alcun rischio di output parziale o di interruzione dovuta a una caduta di tensione.
Passi successivi
Il capitolo finora descrive la struttura generale dell'Open Streaming Format (OSF) e tutti i componenti validi allo stesso modo per OSF4 e OSF5.
Per un'implementazione completa o un'integrazione più approfondita sono utili i seguenti argomenti di approfondimento:
-
Particolarità di OSF4 e OSF5:
-
Vettori e matrici:
- Tipi di canale estesi per dati multidimensionali
- Parametri aggiuntivi per assi, dimensioni e unità fisiche
- Esempi per FFT, classificazioni e dati di immagine
-
Esempi:
- File OSF completi (OSF4/XML e OSF5/JSON) con header, metablock e blocchi di dati
- Hex dump e strutture commentate
-
Accesso al codice sorgente e all'open source:
- Implementazioni di riferimento per OSF4 e OSF5
- Librerie di parser e writer per diverse piattaforme
- Codice di esempio per sistemi embedded e analisi su PC
Questo documento è rilasciato con licenza CC BY 4.0. Attribuzione: optiMEAS GmbH e optiMEAS Switzerland GmbH.